← Inferencia estadística y A/B testing con Python
Axiomas de Kolmogorov, condicional y Bayes
Preview gratis Sección 1 · Probabilidad y distribuciones
Axiomas de Kolmogorov, condicional y Bayes
La inferencia estadística es probabilidad aplicada con disciplina. Antes de hablar de estimadores, intervalos o pruebas, necesitas un marco formal que diga qué significa “la probabilidad de un evento” y cómo actualizarla cuando llega evidencia nueva. Ese marco lo fijó Andréi Kolmogorov en 1933. Esta lectura es la referencia formal de lo que los videos presentan de forma intuitiva, con ejemplos sobre las 244 cuentas de tips.
Los axiomas de Kolmogorov
Una medida de probabilidad es una función $P$ definida sobre eventos, que son subconjuntos de un espacio muestral $\Omega$ con todos los resultados posibles del experimento. Para cualquier evento $A$ debe cumplir:
- No negatividad: $P(A) \geq 0$.
- Normalización: $P(\Omega) = 1$. Algún resultado del espacio muestral ocurre siempre.
- Aditividad numerable: si $A_1, A_2, \ldots$ son mutuamente excluyentes, $P\left(\bigcup_i A_i\right) = \sum_i P(A_i)$.
Todo lo demás se deriva de ahí: $P(\emptyset) = 0$, $P(A^c) = 1 - P(A)$, $0 \leq P(A) \leq 1$ y la regla de la suma para eventos que sí se traslapan:
$$P(A \cup B) = P(A) + P(B) - P(A \cap B)$$Se resta la intersección porque, al sumar $P(A)$ y $P(B)$, esa parte se contó dos veces. Cualquier modelo que uses (binomial, normal, una posterior bayesiana) hereda estas propiedades.
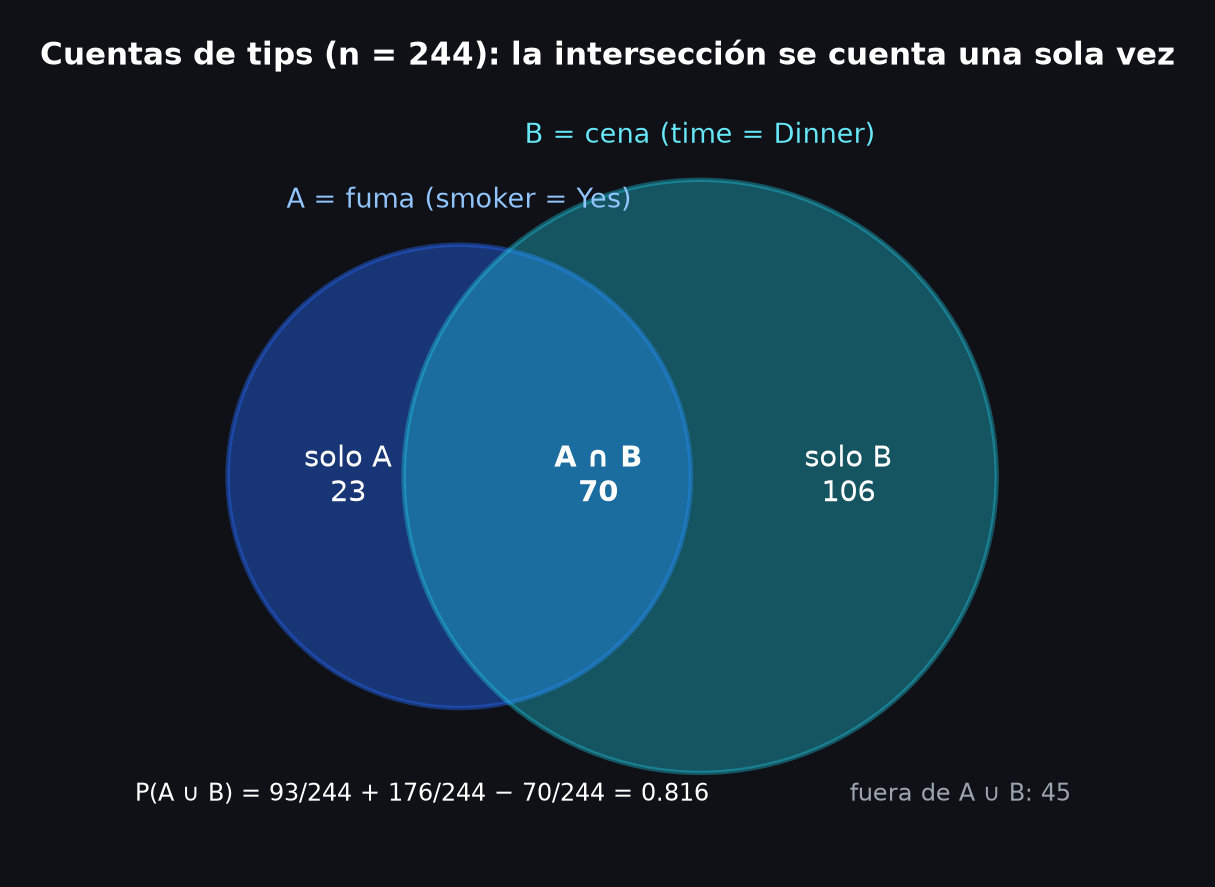
Figura 1. Con A = fuma y B = cena, las 70 cuentas de la intersección se restan una vez: $P(A \cup B) = 199/244 \approx 0.816$.
Probabilidad condicional
La probabilidad de $A$ dado que ocurrió $B$ se define, cuando $P(B) > 0$, como
$$P(A \mid B) = \frac{P(A \cap B)}{P(B)}$$Condicionar es restringir el espacio muestral a $B$ y renormalizar. En tips, $P(\text{fuma}) = 93/244 \approx 0.381$, pero entre las cenas $P(\text{fuma} \mid \text{cena}) = 70/176 \approx 0.398$. Despejando la definición sale la regla del producto: $P(A \cap B) = P(A \mid B)\,P(B) = P(B \mid A)\,P(A)$.
import pandas as pd
import plotly.express as px

tips = px.data.tips()
fuma = tips["smoker"] == "Yes"
print(f"P(fuma) = {fuma.mean():.3f}")  # 0.381

# P(fuma | grupo): proporciones por columna de la tabla de contingencia
print(pd.crosstab(tips["smoker"], tips["time"], normalize="columns").round(3))
print(pd.crosstab(tips["smoker"], tips["day"], normalize="columns").round(3))
Independencia
$A$ y $B$ son independientes cuando $P(A \cap B) = P(A)\,P(B)$; si $P(B) > 0$, equivale a $P(A \mid B) = P(A)$: saber que ocurrió $B$ no cambia la probabilidad de $A$. Con la tabla de arriba, la proporción de fumadores casi no se mueve entre comida (0.34) y cena (0.40), pero el viernes salta a 0.79 y el domingo baja a 0.25.
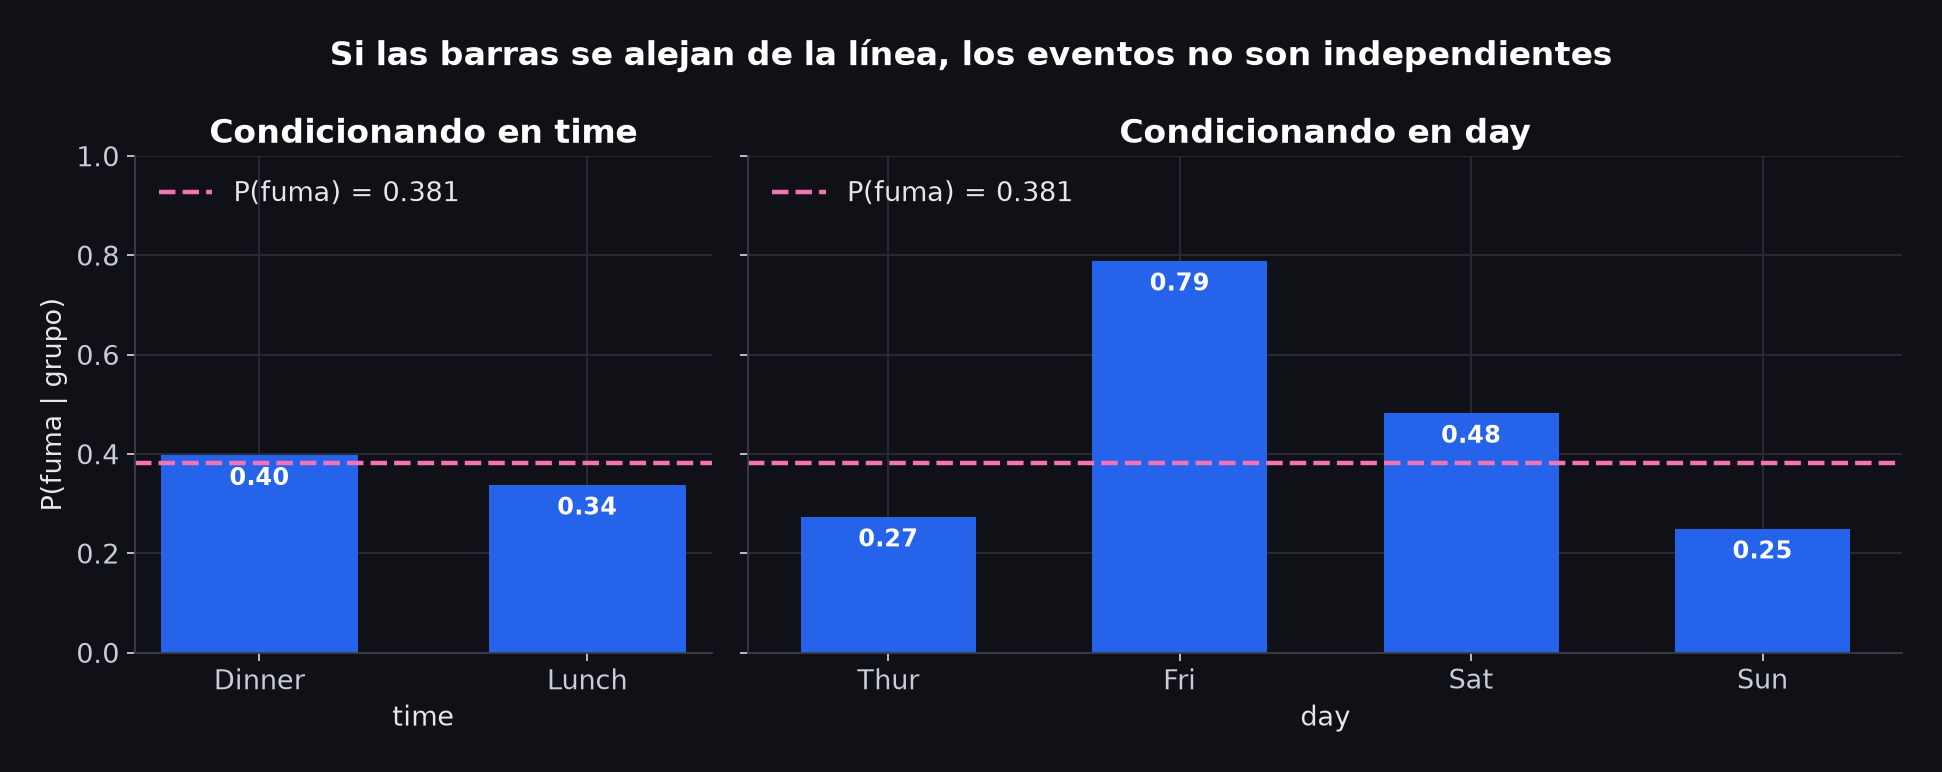
Figura 2. Por time las barras quedan cerca de $P(\text{fuma})$; por day se alejan mucho, señal de dependencia.
Ojo: con datos muestrales las proporciones nunca coinciden exactamente. Decidir si una diferencia como 0.34 contra 0.40 puede deberse al azar es trabajo de una prueba (chi-cuadrado, módulo 3), no de mirar la tabla. Además, dos eventos pueden ser dependientes en conjunto e independientes condicionalmente a una tercera variable, o al revés; esa es la raíz de la paradoja de Simpson.
Probabilidad total y regla de Bayes
Si $H_1, \ldots, H_k$ forman una partición de $\Omega$ (excluyentes y que cubren todo), la ley de probabilidad total dice $P(B) = \sum_i P(B \mid H_i)\,P(H_i)$. Combinándola con la regla del producto sale la regla de Bayes:
$$P(H \mid B) = \frac{P(B \mid H)\,P(H)}{\sum_i P(B \mid H_i)\,P(H_i)}$$$P(H)$ es la probabilidad a priori, $P(B \mid H)$ la verosimilitud y $P(H \mid B)$ la posterior. Una prueba diagnóstica muestra por qué la intuición falla: prevalencia del 4 %, sensibilidad $P(+ \mid \text{enfermo}) = 0.95$ y especificidad $P(- \mid \text{sano}) = 0.95$.
$$P(\text{enfermo} \mid +) = \frac{0.95 \cdot 0.04}{0.95 \cdot 0.04 + 0.05 \cdot 0.96} = \frac{0.038}{0.086} \approx 0.44$$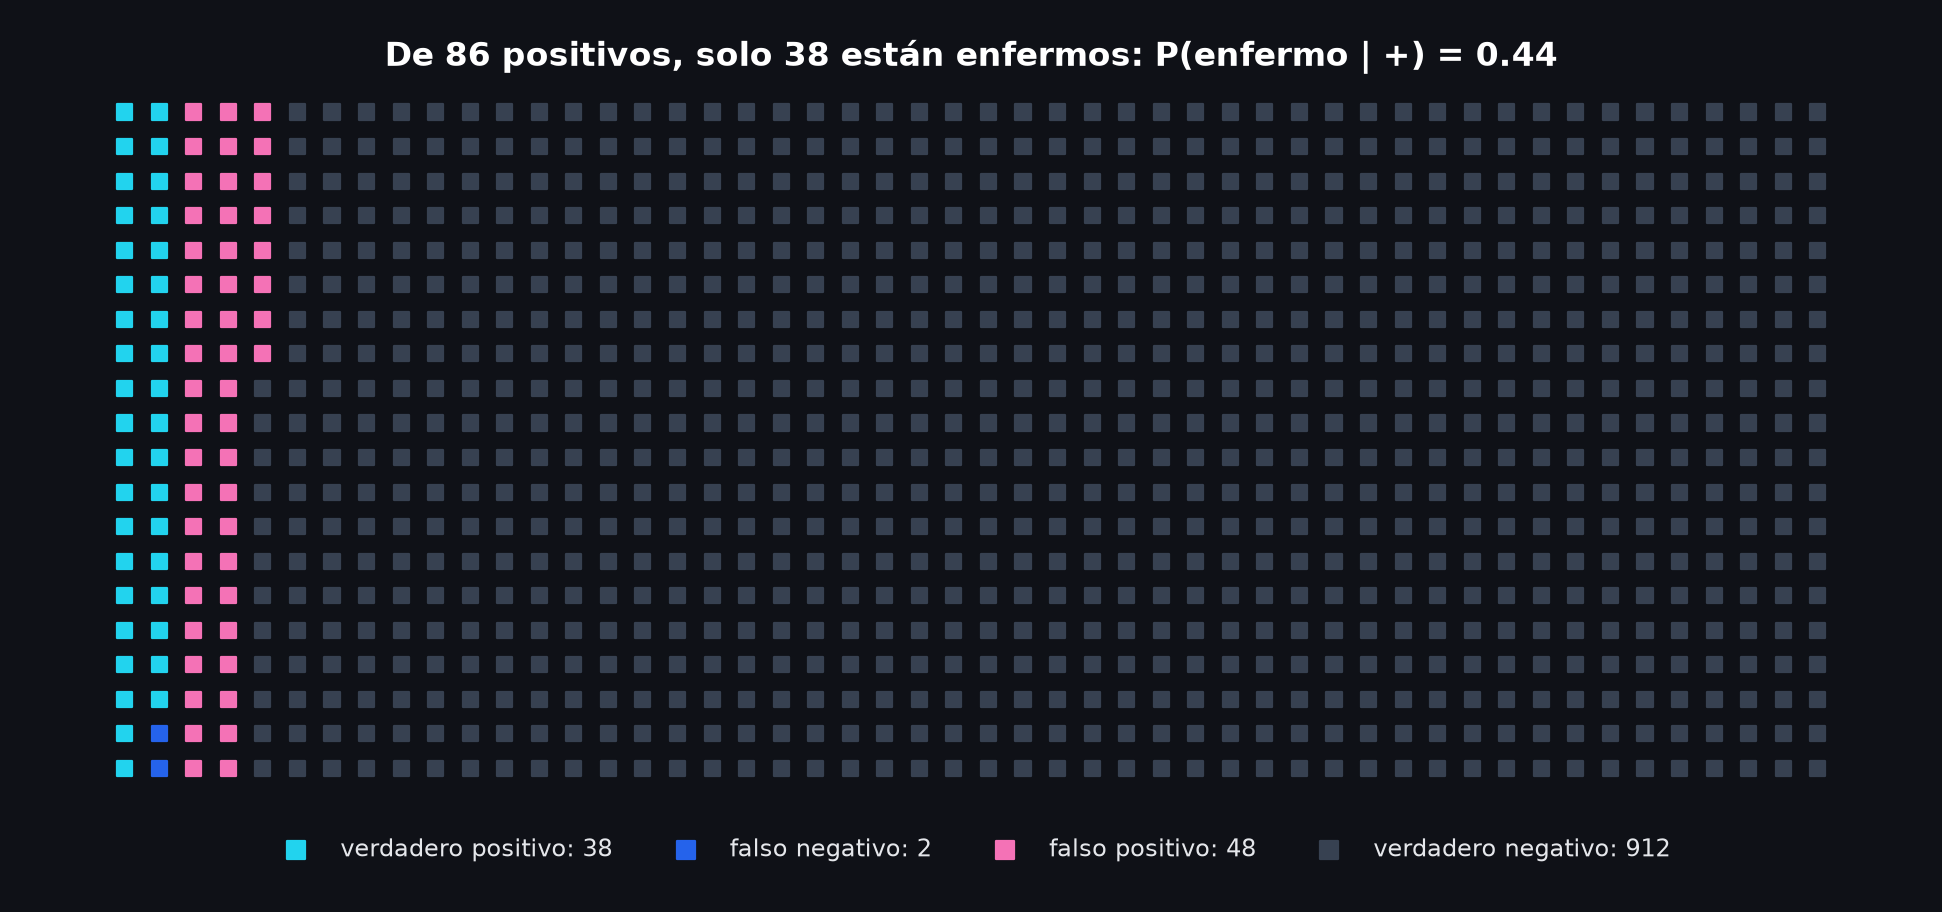
Figura 3. En 1000 personas hay 38 verdaderos positivos y 48 falsos positivos: los sanos son tantos que sus errores dominan.
Una simulación confirma la cuenta:
import numpy as np

rng = np.random.default_rng(42)
n = 100_000
enfermo = rng.random(n) < 0.04
positivo = np.where(enfermo, rng.random(n) < 0.95, rng.random(n) < 0.05)
print(f"P(enfermo | +) = {enfermo[positivo].mean():.3f}")  # cerca de 0.44
Trampas comunes
- Confundir $P(A \mid B)$ con $P(B \mid A)$. Es la falacia del fiscal del caso Sally Clark: la probabilidad de la evidencia dada la inocencia no es la probabilidad de la inocencia dada la evidencia.
- Ignorar la probabilidad a priori. Una sensibilidad del 95 % no dice nada sin la prevalencia; con un 4 % de enfermos, menos de la mitad de los positivos lo están.
- Multiplicar probabilidades sin verificar independencia. $P(A \cap B) = P(A)\,P(B)$ solo vale si son independientes. En series de tiempo, paneles o muestreos por conglomerados, las observaciones rara vez lo son.
- Condicionar en un evento de probabilidad cero. $P(A \mid B)$ no está definida si $P(B) = 0$; y en variables continuas $P(X = c) = 0$ aunque $X$ siempre tome algún valor.
Cierre
Toda la inferencia que sigue habla en probabilidades condicionales. El p-valor es $P(\text{datos tan extremos o más} \mid H_0)$, no $P(H_0 \mid \text{datos})$; el 95 % de un intervalo de confianza es la cobertura del procedimiento en muestras repetidas; una posterior bayesiana es la regla de Bayes aplicada a parámetros. Antes de cualquier técnica, escribe qué espacio muestral usas, en qué evento condicionas y qué independencia estás suponiendo.