Lanzas un producto y la primera pregunta de negocio siempre es la misma: ¿cuántas personas lo van a comprar y cuándo? De la respuesta dependen el presupuesto de anuncios, el inventario, la capacidad de soporte y el momento de lanzar la siguiente versión. El modelo de difusión de Bass es la herramienta clásica de marketing para responderla, y con PyMC-Marketing puedes ajustarlo en Python con pocas líneas y, lo más valioso, con una medida honesta de la incertidumbre.
En este artículo vas a entender la intuición del modelo, qué significa cada parámetro en términos de marketing, en qué casos conviene usarlo y cómo ajustarlo con datos reales de un lanzamiento para pronosticar las semanas que faltan. Todo el código corre tal cual con PyMC-Marketing 1.2.
Qué es el modelo de difusión de Bass
Frank Bass lo publicó en 1969 para pronosticar la venta de bienes duraderos nuevos, como televisores a color y lavavajillas. Su idea central es que cada producto nuevo se adopta por dos caminos distintos:
- Innovadores: compran por influencia externa. Vieron un anuncio, leyeron una reseña o encontraron el producto en Google. No necesitan que nadie más lo haya comprado antes.
- Imitadores: compran por influencia interna. Un colega ya lo usa, alguien lo recomendó en un grupo o lo vieron en casa de un amigo. Mientras más gente lo tiene, más gente nueva lo compra.
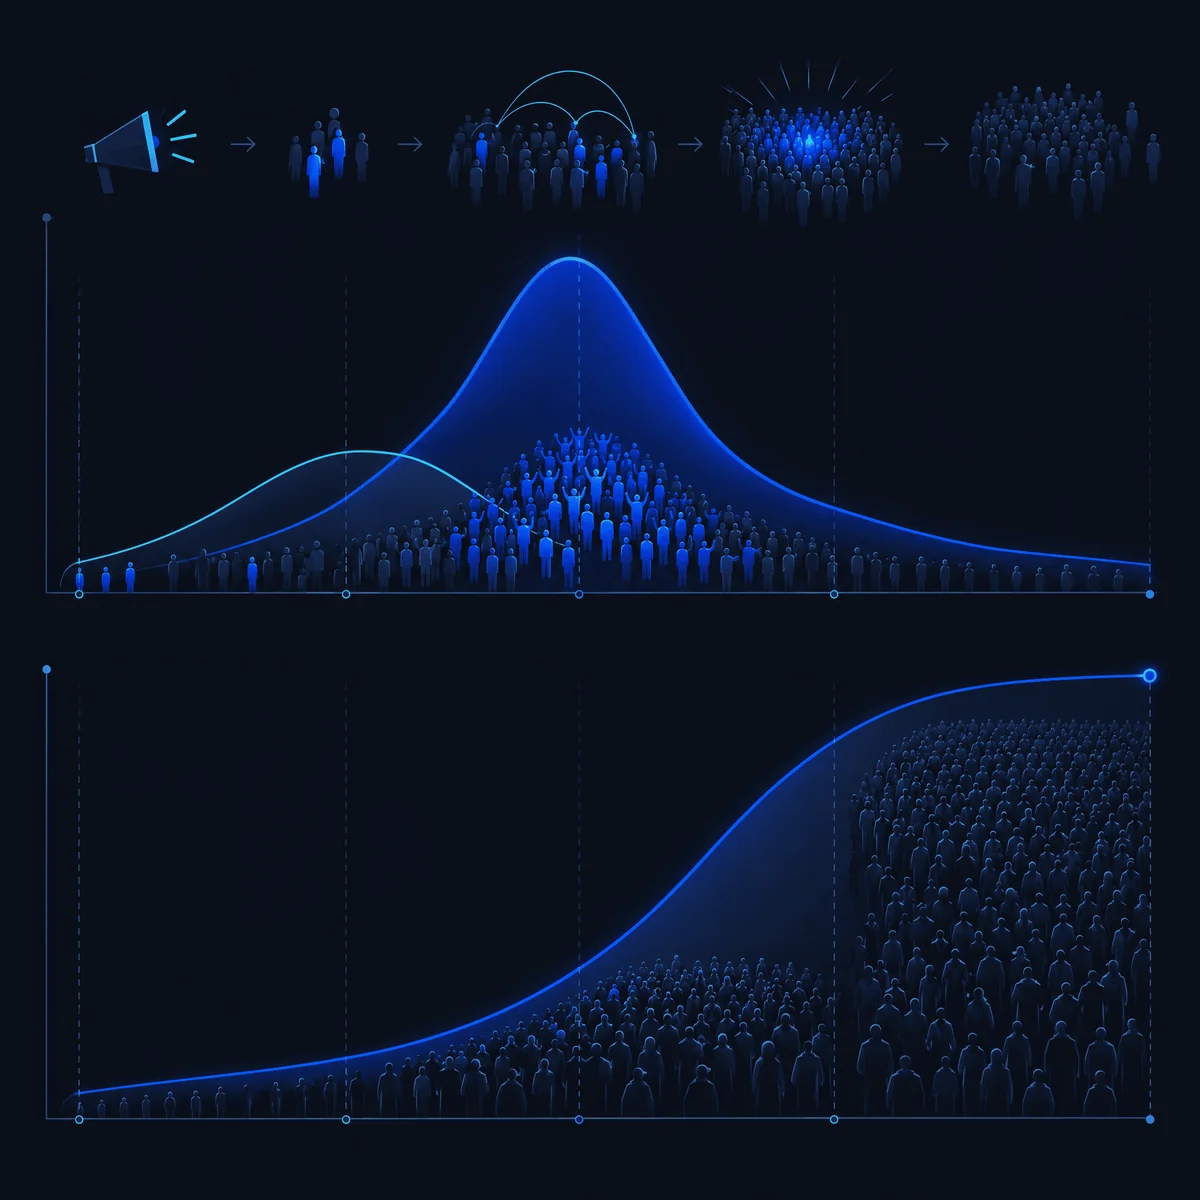
Esa mezcla explica la forma que vemos una y otra vez en ventas de productos nuevos: arranque lento, aceleración, un pico y una caída conforme el mercado se satura. La curva acumulada tiene forma de S y la curva de ventas por periodo tiene forma de campana.
Tip: el modelo de Bass cuenta primeras adopciones: cada persona adopta una sola vez. Funciona para lanzamientos, registros a una app o inscripciones a un curso, no para recompras de un producto de consumo.
La intuición en una sola ecuación
Llama \( F(t) \) a la fracción del mercado que ya adoptó al tiempo \( t \). La pregunta clave es: si alguien todavía no ha adoptado, ¿qué probabilidad tiene de hacerlo justo ahora? Bass la modela así:
\[ \frac{f(t)}{1 - F(t)} = p + q\,F(t) \]Del lado izquierdo está la tasa de adopción entre quienes aún no adoptan. Del lado derecho está toda la intuición del modelo:
- \( p \) es una presión constante: la publicidad empuja igual en la semana 1 que en la semana 30.
- \( q\,F(t) \) crece con la base instalada: al principio casi nadie tiene el producto y el boca a boca no pesa, pero conforme \( F(t) \) sube, cada persona que aún no adopta tiene más contacto con quienes ya lo hicieron.
Resolver esa ecuación da la curva acumulada y la curva de ventas:
\[ F(t) = \frac{1 - e^{-(p+q)t}}{1 + \frac{q}{p}\,e^{-(p+q)t}} \qquad f(t) = \big(p + q\,F(t)\big)\big(1 - F(t)\big) \]Si el mercado total es de \( m \) personas, las ventas del periodo son \( m \cdot f(t) \). De aquí salen tres resultados muy útiles para planear:
- Momento del pico: \( t^* = \dfrac{\ln(q/p)}{p+q} \). Solo existe si \( q > p \); si la publicidad domina, las ventas son máximas desde el lanzamiento y luego bajan.
- Ventas en el pico: \( m \cdot \dfrac{(p+q)^2}{4q} \).
- Mercado cubierto al llegar al pico: \( F(t^*) = \dfrac{q-p}{2q} \), un poco menos de la mitad cuando \( q \) es mucho mayor que \( p \).
Los parámetros explicados desde marketing
| Parámetro | Qué mide | Palanca de marketing | Valor típico (anual) |
|---|---|---|---|
| \( m \) | Mercado potencial: cuántas personas terminarán adoptando | Posicionamiento, precio, a quién te diriges | Depende del producto |
| \( p \) | Coeficiente de innovación: influencia externa | Medios pagados, SEO, prensa, lanzamiento | ~0.03 |
| \( q \) | Coeficiente de imitación: influencia interna | Referidos, comunidad, reseñas, experiencia de uso | ~0.38 |
Los valores típicos vienen del meta-análisis de Sultan, Farley y Lehmann (1990) sobre más de 200 aplicaciones del modelo: en promedio \( p \approx 0.03 \) y \( q \approx 0.38 \). La conclusión práctica es que, para la mayoría de los productos, el boca a boca pesa unas diez veces más que la influencia externa.
Tip: \( p \) y \( q \) dependen de la unidad de tiempo. Los valores anteriores son anuales y vienen de bienes duraderos. Si trabajas con datos semanales, divide ambos entre 52: el modelo es el mismo, solo cambia la escala. Un producto digital suele difundirse mucho más rápido que un refrigerador, así que no copies valores de la literatura sin revisar la unidad.
La razón \( q/p \) define la forma de la curva. Si es grande, el arranque es lento y el pico es marcado; si es cercana a 1 o menor, las ventas son más parejas o empiezan en su máximo. Veamos los escenarios con código.
Ejemplo 1: la intuición con NumPy
Antes de usar cualquier librería, implementa las ecuaciones a mano. Así entiendes qué hace el modelo por dentro. Aquí la unidad de tiempo son años.
import numpy as np


def bass_F(t, p, q):
    """Fracción acumulada del mercado que ya adoptó al tiempo t."""
    e = np.exp(-(p + q) * t)
    return (1 - e) / (1 + (q / p) * e)


def bass_f(t, p, q):
    """Fracción del mercado que adopta justo en t (la curva de ventas)."""
    F = bass_F(t, p, q)
    return (p + q * F) * (1 - F)


def momento_pico(p, q):
    """t* = ln(q/p) / (p + q). Si q <= p no hay pico: se vende más al inicio."""
    return max(0.0, np.log(q / p) / (p + q))


anios = np.linspace(0, 20, 2001)
escenarios = {
    "Empujado por publicidad": (0.10, 0.15),
    "Promedio histórico":      (0.03, 0.38),
    "Viral, casi sin anuncios": (0.005, 0.60),
    "Solo publicidad (q < p)":  (0.20, 0.10),
}

for nombre, (p, q) in escenarios.items():
    F = bass_F(anios, p, q)
    mitad = anios[np.argmax(F >= 0.5)]
    print(f"{nombre:26s} p={p:<5} q={q:<4} | pico: año {momento_pico(p, q):4.1f}"
          f" | 50% del mercado: año {mitad:4.1f}")
Empujado por publicidad p=0.1 q=0.15 | pico: año 1.6 | 50% del mercado: año 5.0
Promedio histórico p=0.03 q=0.38 | pico: año 6.2 | 50% del mercado: año 6.6
Viral, casi sin anuncios p=0.005 q=0.6 | pico: año 7.9 | 50% del mercado: año 8.0
Solo publicidad (q < p) p=0.2 q=0.1 | pico: año 0.0 | 50% del mercado: año 3.1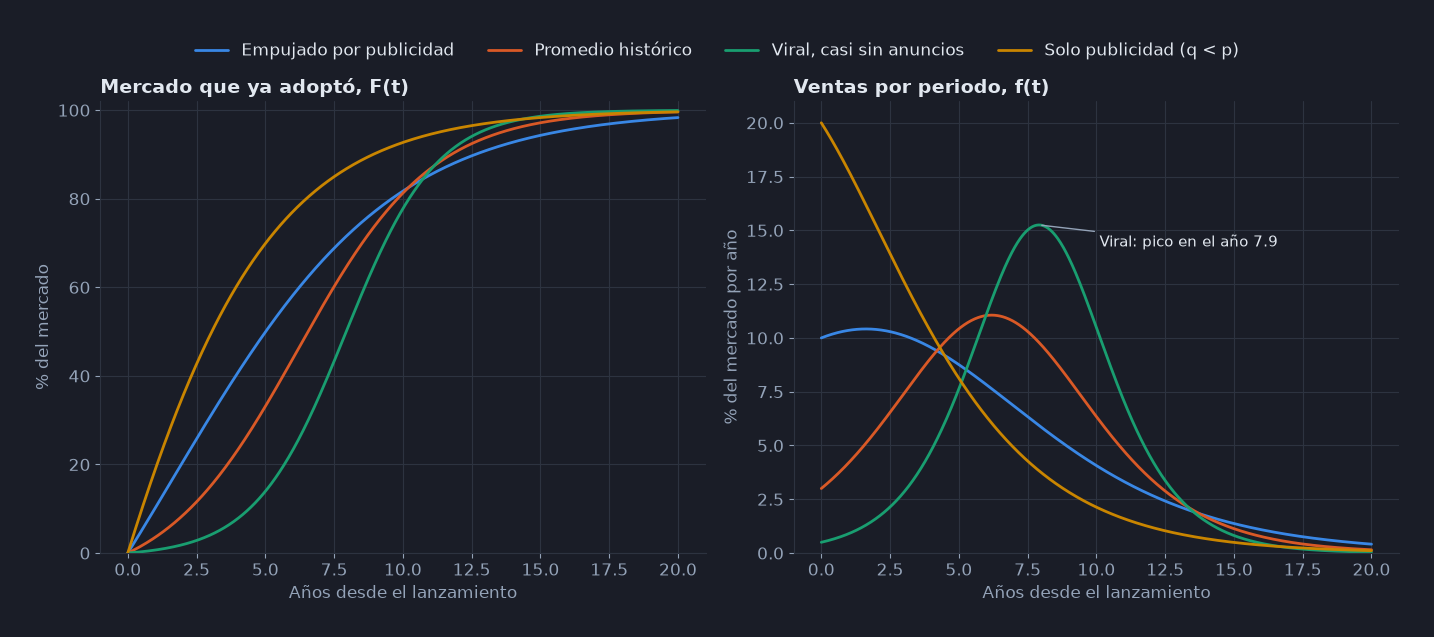
Hay tres lecciones en esa tabla y en la gráfica:
- La publicidad compra velocidad al inicio. Con \( p \) alto llegas al 10% del mercado en cuestión de meses, pero el crecimiento después es lento: el escenario empujado por publicidad tarda 11.6 años en pasar del 10% al 90% del mercado.
- El boca a boca compra aceleración. El producto viral tarda más de cuatro años en llegar al 10%, pero del 10% al 90% pasa en solo 7.1 años. Su curva de ventas es una campana alta y estrecha.
- Sin imitación no hay pico. Cuando \( q < p \), el máximo de ventas ocurre en el lanzamiento y de ahí solo baja. Si tus ventas se comportan así, el producto depende por completo de tu inversión en medios.
Casos de uso del modelo de Bass en marketing
- Pronóstico antes del lanzamiento. Sin datos propios, usas \( p \) y \( q \) de productos análogos y estimas \( m \) con tu investigación de mercado. Así se pronosticó la adopción de DIRECTV antes de lanzarla (Bass y coautores, 2001).
- Pronóstico temprano. Con las primeras semanas de ventas actualizas el pronóstico y sabes cuánto falta por venderse y cuándo llega el pico. Es el ejemplo que vas a construir abajo.
- Planeación de capacidad. El momento del pico te dice cuándo necesitas más inventario, más servidores o más gente en soporte, y cuándo puedes reducirlos.
- Mezcla de marketing. Si el modelo encuentra un \( q \) alto, invertir en referidos y comunidad rinde más que seguir comprando anuncios. Si domina \( p \), tus ventas dependen de los medios pagados.
- Saturación y siguiente versión. Cuando \( F(t) \) supera el 80% o 90%, quedan pocos compradores nuevos. Es la señal para lanzar la siguiente versión o el siguiente producto.
- Comparar lanzamientos. Ajustar varios productos con el mismo modelo te dice cuáles se difundieron por publicidad y cuáles por recomendación.
Ejemplo 2: simular el lanzamiento de un curso online
Para comprobar que el modelo recupera la verdad, primero simula datos con parámetros conocidos: un curso online con un mercado de 6,000 alumnos potenciales, \( p = 0.012 \) y \( q = 0.15 \) por semana. Las inscripciones semanales llevan ruido, como en la vida real.
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)

# Lo que queremos recuperar: un curso online con 6,000 alumnos potenciales
M_REAL, P_REAL, Q_REAL = 6_000, 0.012, 0.15   # p y q SEMANALES
semanas = np.arange(52)

e = np.exp(-(P_REAL + Q_REAL) * semanas)
F = (1 - e) / (1 + (Q_REAL / P_REAL) * e)
esperadas = M_REAL * (P_REAL + Q_REAL * F) * (1 - F)

# Las inscripciones reales traen ruido: semanas buenas y malas
inscripciones = rng.negative_binomial(n=20, p=20 / (20 + esperadas))
serie = pd.Series(inscripciones, index=pd.Index(semanas, name="T"), name="observed")

print(f"Total del año: {serie.sum():,} | semana con más inscripciones: {serie.idxmax()}")
Total del año: 5,785 | semana con más inscripciones: 19Ejemplo 3: ajustar el modelo de Bass con PyMC-Marketing
Instala la librería. nutpie es un sampler escrito en Rust que acelera mucho el ajuste, y en Windows evita depender de un compilador de C:
pip install "pymc-marketing>=1.2" nutpie matplotlibPyMC-Marketing trae la clase BassModel. Solo le das tus priors y la serie de adopciones por periodo. Los priors son la parte donde tu conocimiento del negocio entra al modelo:
- m: una Gamma centrada en 6,000 con desviación de 2,000. Dice "creo que el mercado ronda los 6,000, pero podría ser 3,000 o 10,000".
- p: una Beta(2, 100), con media cercana a 0.02 semanal. Pocos alumnos llegan solos.
- q: una Beta(3, 15), con media cercana a 0.17 semanal. Esperamos que la recomendación pese más.
- likelihood: una binomial negativa, porque los conteos de marketing varían más de lo que permite una Poisson.
import arviz as az
from pymc_extras.prior import Prior
from pymc_marketing.bass import BassModel

priors = {
    # m: creemos que el mercado ronda 6,000 alumnos, con bastante duda
    "m": Prior("Gamma", mu=6_000, sigma=2_000),
    # p semanal: pocos llegan solos (anuncios, SEO). Media ~0.02
    "p": Prior("Beta", alpha=2, beta=100),
    # q semanal: el boca a boca pesa más. Media ~0.17
    "q": Prior("Beta", alpha=3, beta=15),
    # Conteos con más variación que una Poisson
    "likelihood": Prior("NegativeBinomial", n=Prior("HalfNormal", sigma=30)),
}

sampler = {
    "draws": 1_000, "tune": 1_000, "chains": 4,
    "nuts_sampler": "nutpie", "compile_kwargs": {"mode": "NUMBA"},
}

modelo = BassModel(model_config=priors, sampler_config=sampler)
idata = modelo.fit(serie, random_seed=42)

print(az.summary(idata, var_names=["m", "p", "q"], kind="stats"))
mean sd eti89_lb eti89_ub
m 5800 230 5500 6200
p 0.013 0.0012 0.011 0.015
q 0.14 0.0059 0.13 0.15Con el año completo de datos, el modelo recupera los parámetros reales: \( m \approx 5,800 \) (real 6,000), \( p \approx 0.013 \) (real 0.012) y \( q \approx 0.14 \) (real 0.15). Las columnas eti89 son el intervalo de credibilidad del 89%: hay 89% de probabilidad de que el valor real esté en ese rango, dados los datos y los priors.
Ejemplo 4: pronosticar con solo 10 semanas de datos
Ajustar con el año completo sirve para validar, pero no ayuda a decidir: para entonces ya sabes cuánto vendiste. El caso valioso es este: vas en la semana 10 del lanzamiento y necesitas saber cuánto falta, cuándo llega el pico y si tu crecimiento viene de los anuncios o de las recomendaciones.
import xarray as xr

# Semana 10 del lanzamiento: es todo lo que sabemos
primeras = serie.iloc[:10]
modelo = BassModel(model_config=priors, sampler_config=sampler)
idata = modelo.fit(primeras, random_seed=42)
post = idata.posterior

# Pronóstico de las 52 semanas completas
pronostico = modelo.sample_posterior_predictive(
    X=xr.Dataset(coords={"T": np.arange(52)}),
    extend_idata=False,
    random_seed=42,
)


def rango(x, dim):
    bajo, medio, alto = x.quantile([0.055, 0.5, 0.945], dim=dim).values
    return f"{medio:,.0f} (89%: {bajo:,.0f} a {alto:,.0f})"


muestras = ("chain", "draw")
print("Mercado total (m)    :", rango(post["m"], muestras))
print("Semana del pico      :", rango(post["peak"], muestras))
print("Inscripciones del año:", rango(pronostico.sum("T"), "sample"))
print("Faltan por llegar    :", rango(pronostico.sel(T=slice(10, None)).sum("T"), "sample"))

# ¿Cuánto viene de anuncios (innovadores) y cuánto del boca a boca (imitadores)?
t = xr.DataArray(np.arange(52), dims="T")
p, q = post["p"], post["q"]
e = np.exp(-(p + q) * t)
F = (1 - e) / (1 + (q / p) * e)
por_anuncios = (p * (1 - F)).sum("T")
por_boca_a_boca = (q * F * (1 - F)).sum("T")
print("% por anuncios (año) :",
      rango(100 * por_anuncios / (por_anuncios + por_boca_a_boca), muestras))
Mercado total (m) : 5,142 (89%: 3,076 a 8,545)
Semana del pico : 14 (89%: 10 a 19)
Inscripciones del año: 5,162 (89%: 3,077 a 8,572)
Faltan por llegar : 3,823 (89%: 1,717 a 7,193)
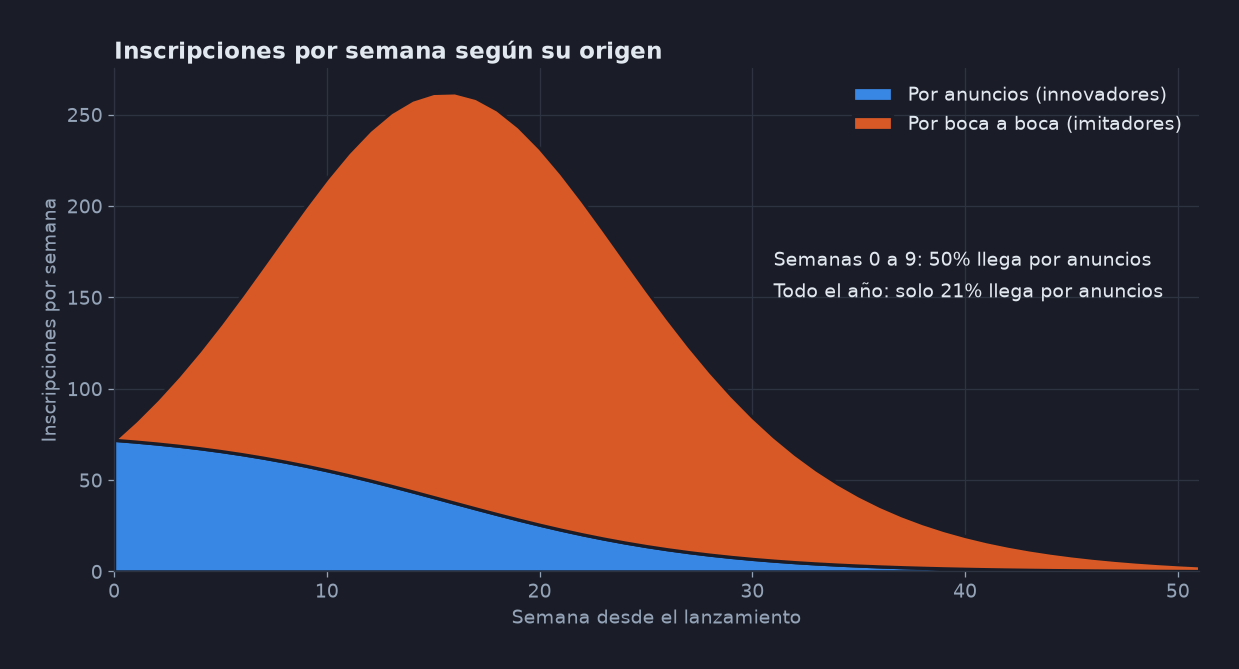
% por anuncios (año) : 22 (89%: 15 a 31)Compara contra lo que realmente pasó en la simulación:
| Pregunta de negocio | Pronóstico en la semana 10 | Lo que pasó |
|---|---|---|
| Inscripciones del año | 5,162 (3,077 a 8,572) | 5,785 |
| Faltan por llegar | 3,823 (1,717 a 7,193) | 4,421 |
| Semana del pico | 14 (10 a 19) | 15.6 (valor real del modelo) |
| % del año que viene por anuncios | 22% (15% a 31%) | 21% |
Todo lo real cae dentro de los intervalos, pero fíjate en lo anchos que son. Con 10 semanas todavía no has visto el pico, y el modelo no puede distinguir bien entre un mercado chico que se satura rápido y uno grande que apenas arranca. Esa incertidumbre es información, no un defecto: te dice que no comprometas todo el inventario del año con base en diez semanas. Reajusta cada semana y verás cómo los intervalos se cierran.
El último dato también es útil para tu estrategia: aunque en las primeras semanas cerca de la mitad de las inscripciones vienen de los anuncios, en el año completo solo alrededor del 22% llega por esa vía. El resto lo trae el boca a boca, y eso justifica invertir en referidos y comunidad desde temprano.
Ejemplo 5: visualizar el pronóstico
Una gráfica comunica el pronóstico mucho mejor que una tabla, sobre todo a quien no es técnico:
import matplotlib.pyplot as plt

bajo, medio, alto = pronostico.quantile([0.055, 0.5, 0.945], dim="sample")

fig, ax = plt.subplots(figsize=(10, 5))
ax.fill_between(bajo["T"], bajo, alto, alpha=0.3, label="Pronóstico (89%)")
ax.plot(medio["T"], medio, label="Pronóstico (mediana)")
ax.scatter(serie.index[:10], serie.iloc[:10], color="black", zorder=3,
           label="Lo que sabíamos (semanas 0-9)")
ax.scatter(serie.index[10:], serie.iloc[10:], color="gray", s=12,
           label="Lo que pasó después")
ax.axvline(9.5, ls="--", color="gray")
ax.set_xlabel("Semana desde el lanzamiento")
ax.set_ylabel("Inscripciones por semana")
ax.legend()
plt.show()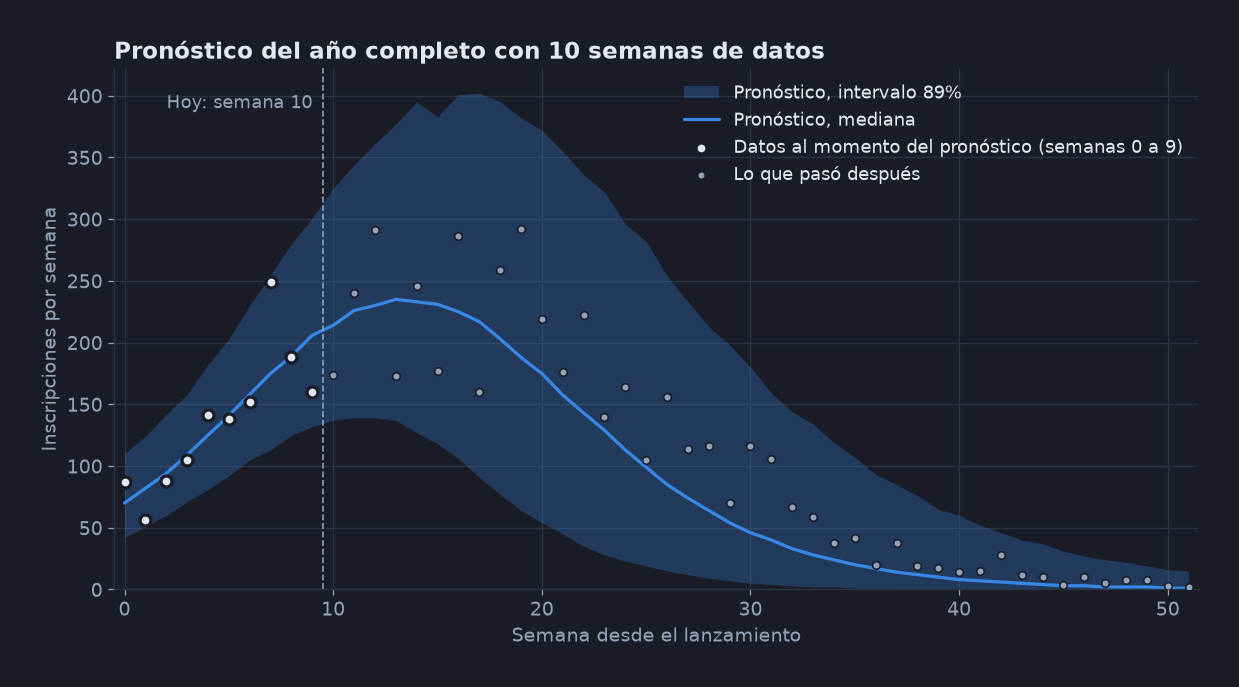
La banda del 89% se abre después de la semana 10 porque el modelo todavía no ha visto el pico. Esa es la gráfica que llevas a una junta de planeación: comunica el pronóstico y cuánto confiar en él en una sola imagen.
Cómo elegir buenos priors
Con pocos datos, los priors pesan mucho en el resultado. Estas son fuentes razonables:
- Para m: tu estimación del mercado alcanzable. Por ejemplo, tu lista de correo, el tráfico mensual del sitio y tu tasa de conversión histórica. Usa una desviación amplia si no estás seguro.
- Para p y q: lanzamientos anteriores de tu propia empresa. Si ya ajustaste el modelo a tres cursos anteriores, sus valores de \( p \) y \( q \) son el mejor punto de partida para el cuarto.
- Revisa la unidad de tiempo: un prior anual usado con datos semanales da pronósticos absurdos.
Tip: antes de ajustar, simula datos desde tus priors (prior predictive check). Si tus priors generan cursos con 200,000 inscripciones o lanzamientos que terminan en dos semanas, están mal calibrados.
Limitaciones y extensiones
- El mercado es fijo. El modelo asume que \( m \) no cambia. Si bajas el precio o abres un país nuevo, el mercado cambia y el modelo se queda atrás.
- No incluye tus decisiones de marketing. El modelo básico no sabe cuándo subiste el presupuesto de anuncios. El Modelo de Bass Generalizado (Bass, Krishnan y Jain, 1994) agrega precio y publicidad como variables.
- Una adopción por persona. No sirve para recompras. Para eso existen modelos de valor de vida del cliente, que PyMC-Marketing también incluye.
- Varios productos a la vez.
BassModelacepta varios productos en un mismoxarray.Datasetcon una dimensiónproduct, útil para comparar lanzamientos.
Conclusión
El modelo de difusión de Bass reduce la adopción de un producto a tres números con significado de negocio: el tamaño del mercado \( m \), la influencia externa \( p \) y el boca a boca \( q \). Los puntos clave:
- La probabilidad de adoptar es \( p + q\,F(t) \): la publicidad empuja constante y la recomendación crece con la base instalada.
- El pico llega en \( t^* = \ln(q/p)/(p+q) \) y solo existe cuando el boca a boca supera a la influencia externa.
- Los valores típicos anuales son \( p \approx 0.03 \) y \( q \approx 0.38 \), pero dependen de la unidad de tiempo y del tipo de producto.
- Con PyMC-Marketing ajustas el modelo en segundos con
BassModely obtienes intervalos de credibilidad, no solo un número. - El uso más valioso es el pronóstico temprano: con las primeras semanas de datos sabes cuánto falta por venderse, cuándo llega el pico y qué canal está trayendo a tus clientes.
El siguiente paso es aplicarlo a un lanzamiento tuyo: toma las ventas o registros semanales de tu último producto, ajusta el modelo con las primeras semanas y compara el pronóstico contra lo que realmente pasó. Esa comparación te dará priors mucho mejores para tu próximo lanzamiento.