Elegir base de datos parece una decisión técnica, pero es una decisión de negocio. De ella depende que un pago nunca quede a medias, que tu catálogo crezca sin migraciones eternas, que la página de producto cargue rápido en temporada alta y que puedas sacar un reporte de ventas sin pedirle ayuda a nadie. La discusión de bases de datos relacionales vs no relacionales (SQL vs NoSQL) suele plantearse como si una fuera mejor que la otra. No lo es: cada una resuelve problemas distintos.
En este artículo vas a ver para qué funciona mejor cada tipo, con ejemplos concretos de negocio, los pros y contras de las tecnologías más usadas (PostgreSQL, MySQL, SQLite, MongoDB, Redis, DynamoDB, Cassandra, Neo4j y OpenSearch) y código en Python que puedes correr sin instalar ningún servidor.
La pregunta correcta no es cuál es mejor
Antes de comparar tecnologías, responde tres preguntas sobre tus datos:
- ¿Qué pasa si un dato queda mal? Si es un pago, un saldo o el inventario, el costo de un error es dinero perdido o un cliente molesto. Si es un contador de visitas, nadie lo nota.
- ¿Cómo lo vas a leer? No es lo mismo cruzar clientes, pedidos y productos en un reporte que traer la ficha completa de un producto con una sola lectura.
- ¿Cómo va a crecer? Miles de pedidos al día caben cómodos en un solo servidor. Millones de lecturas de sensores por minuto, no.
Con esas respuestas la elección casi se hace sola. Veamos por qué.
Bases de datos relacionales: reglas que protegen tu dinero
Una base relacional guarda los datos en tablas con un esquema definido: columnas con tipo, llaves que conectan una tabla con otra y reglas que la propia base hace cumplir. Se consulta con SQL, un lenguaje declarativo: pides qué quieres y la base decide cómo obtenerlo.
Su gran ventaja de negocio se resume en las siglas ACID:
- Atomicidad: una operación de varios pasos ocurre completa o no ocurre. Nunca se cobra un pedido que no se registró.
- Consistencia: las reglas (stock no negativo, cliente existente, precio positivo) se cumplen siempre.
- Aislamiento: dos operaciones simultáneas no se pisan; dos clientes no compran la misma última unidad.
- Durabilidad: lo confirmado sobrevive a un reinicio o a un corte de luz.
El siguiente ejemplo usa SQLite, que viene incluido en Python, para mostrar lo que significa atomicidad en un pedido real: si falta stock de un solo producto, no se guarda nada del pedido.
import sqlite3

con = sqlite3.connect(":memory:")
con.execute("PRAGMA foreign_keys = ON")
con.executescript("""
CREATE TABLE clientes (
    id     INTEGER PRIMARY KEY,
    nombre TEXT NOT NULL,
    email  TEXT NOT NULL UNIQUE
);
CREATE TABLE productos (
    id     INTEGER PRIMARY KEY,
    nombre TEXT NOT NULL,
    precio REAL NOT NULL CHECK (precio > 0),
    stock  INTEGER NOT NULL CHECK (stock >= 0)   -- la base no permite stock negativo
);
CREATE TABLE pedidos (
    id         INTEGER PRIMARY KEY,
    cliente_id INTEGER NOT NULL REFERENCES clientes(id),
    total      REAL NOT NULL
);
CREATE TABLE pedido_items (
    pedido_id   INTEGER NOT NULL REFERENCES pedidos(id),
    producto_id INTEGER NOT NULL REFERENCES productos(id),
    cantidad    INTEGER NOT NULL CHECK (cantidad > 0),
    precio      REAL NOT NULL
);
""")
con.executemany("INSERT INTO clientes VALUES (?, ?, ?)",
                [(1, "Ana", "ana@ejemplo.com"), (2, "Luis", "luis@ejemplo.com")])
con.executemany("INSERT INTO productos VALUES (?, ?, ?, ?)",
                [(1, "Teclado", 899.0, 10), (2, "Monitor", 4599.0, 2)])
con.commit()


def crear_pedido(con, cliente_id, items):
    """Todo o nada: si un producto no tiene stock, no se guarda NADA del pedido."""
    with con:  # abre una transacción; hace COMMIT al salir o ROLLBACK si hay error
        precios = dict(con.execute("SELECT id, precio FROM productos"))
        total = sum(precios[p] * c for p, c in items)
        pedido_id = con.execute(
            "INSERT INTO pedidos (cliente_id, total) VALUES (?, ?)", (cliente_id, total)
        ).lastrowid
        for producto_id, cantidad in items:
            con.execute("UPDATE productos SET stock = stock - ? WHERE id = ?",
                        (cantidad, producto_id))
            con.execute("INSERT INTO pedido_items VALUES (?, ?, ?, ?)",
                        (pedido_id, producto_id, cantidad, precios[producto_id]))
        return pedido_id


print("Pedido de Ana:", crear_pedido(con, 1, [(1, 2), (2, 1)]))
try:
    crear_pedido(con, 2, [(1, 3), (2, 5)])  # pide 5 monitores y solo queda 1
except sqlite3.IntegrityError as e:
    print("Pedido de Luis rechazado:", e)

print("Stock:", con.execute("SELECT nombre, stock FROM productos").fetchall())
print("Pedidos guardados:", con.execute("SELECT COUNT(*) FROM pedidos").fetchone()[0])

# Un reporte de negocio es una sola consulta con JOIN
reporte = con.execute("""
    SELECT c.nombre, COUNT(DISTINCT p.id) AS pedidos, SUM(i.cantidad * i.precio) AS vendido
    FROM clientes c
    LEFT JOIN pedidos p      ON p.cliente_id = c.id
    LEFT JOIN pedido_items i ON i.pedido_id = p.id
    GROUP BY c.id ORDER BY vendido DESC
""").fetchall()
print("Ventas por cliente:", reporte)
Pedido de Ana: 1
Pedido de Luis rechazado: CHECK constraint failed: stock >= 0
Stock: [('Teclado', 8), ('Monitor', 1)]
Pedidos guardados: 1
Ventas por cliente: [('Ana', 1, 6397.0), ('Luis', 0, None)]Observa el detalle importante: el pedido de Luis alcanzó a descontar tres teclados antes de fallar en los monitores, pero el stock de teclados sigue en 8. La transacción revirtió todo. Esa garantía es la que quieres para pagos, facturación, inventario y cualquier dato que termine en un estado de cuenta. Además, el reporte de ventas por cliente es una sola consulta con JOIN: el modelo relacional brilla cuando necesitas cruzar información que no sabías que ibas a cruzar.
Bases de datos no relacionales: cuatro familias, cuatro problemas
NoSQL no es una tecnología, es una categoría que agrupa bases diseñadas para patrones de acceso específicos. A cambio de relajar alguna garantía o de renunciar a los JOIN, cada familia es excelente en algo. La regla general: en NoSQL modelas pensando en las consultas que vas a hacer, no en los datos.
Documentos: MongoDB
Guardan cada registro como un documento tipo JSON que puede tener campos distintos al de junto. Es ideal para catálogos con atributos variables, perfiles de usuario y contenido. Para correr el ejemplo sin servidor, instala los clientes y sus simuladores en memoria:
pip install pymongo mongomock redis fakeredismongomock imita la API de pymongo: el mismo código funciona contra un MongoDB real cambiando una sola línea.
import mongomock  # en producción: from pymongo import MongoClient

client = mongomock.MongoClient()  # en producción: MongoClient("mongodb://...")
catalogo = client.tienda.productos

# Cada tipo de producto trae atributos distintos, y no hace falta migrar nada
catalogo.insert_many([
    {"sku": "LAP-01", "tipo": "laptop", "precio": 18999, "ram_gb": 16, "cpu": "Ryzen 7"},
    {"sku": "LAP-02", "tipo": "laptop", "precio": 12999, "ram_gb": 8, "cpu": "Core i5"},
    {"sku": "PLA-01", "tipo": "playera", "precio": 349, "talla": "M", "color": "negro"},
    {"sku": "PLA-02", "tipo": "playera", "precio": 349, "talla": "L", "color": "blanco"},
    {"sku": "LIB-01", "tipo": "libro", "precio": 599, "autor": "Ana Pérez",
     "titulo": "Estadística aplicada", "paginas": 320},
])
catalogo.create_index("tipo")

# Consultas sobre atributos que solo tienen algunos productos
potentes = catalogo.find({"tipo": "laptop", "ram_gb": {"$gte": 16}}, {"_id": 0, "sku": 1, "cpu": 1})
print("Laptops con 16 GB o más:", list(potentes))
print("Playeras negras:", [p["sku"] for p in catalogo.find({"color": "negro"})])

# Agregaciones tipo GROUP BY con un pipeline
resumen = catalogo.aggregate([
    {"$group": {"_id": "$tipo", "productos": {"$sum": 1}, "precio_promedio": {"$avg": "$precio"}}},
    {"$sort": {"_id": 1}},
])
for fila in resumen:
    print(f"{fila['_id']:8s} productos={fila['productos']}  precio promedio=${fila['precio_promedio']:,.0f}")

# Un pedido guarda todo lo que necesita mostrar en un solo documento
pedidos = client.tienda.pedidos
pedidos.insert_one({
    "cliente": {"nombre": "Ana", "email": "ana@ejemplo.com"},
    "items": [{"sku": "LAP-01", "precio": 18999, "cantidad": 1}],
    "total": 18999,
})
print("Pedido en una sola lectura:", pedidos.find_one({}, {"_id": 0}))

# El costo: si Ana cambia su correo, hay que actualizarlo en cada pedido copiado
r = pedidos.update_many({"cliente.email": "ana@ejemplo.com"},
                        {"$set": {"cliente.email": "ana.nueva@ejemplo.com"}})
print("Documentos a corregir:", r.modified_count)
Laptops con 16 GB o más: [{'sku': 'LAP-01', 'cpu': 'Ryzen 7'}]
Playeras negras: ['PLA-01']
laptop productos=2 precio promedio=$15,999
libro productos=1 precio promedio=$599
playera productos=2 precio promedio=$349
Pedido en una sola lectura: {'cliente': {'nombre': 'Ana', 'email': 'ana@ejemplo.com'}, 'items': [{'sku': 'LAP-01', 'precio': 18999, 'cantidad': 1}], 'total': 18999}
Documentos a corregir: 1Tres lecciones de negocio. Primero, agregar un tipo de producto nuevo con atributos propios no requiere migrar la base. Segundo, un pedido se lee completo en una sola consulta, sin juntar tablas. Tercero, el costo: copiar datos del cliente dentro de cada pedido significa que, si el cliente cambia su correo, hay que corregirlo en todos sus pedidos. Con un pedido no pasa nada; con cien mil pedidos repartidos en años, sí.
Clave-valor: Redis, Valkey y DynamoDB
Guardan un valor por cada clave y lo devuelven muy rápido. Redis y Valkey viven en memoria y responden en menos de un milisegundo, así que son la opción natural para caché, sesiones, carritos, contadores y rankings. DynamoDB, de AWS, es un servicio administrado de clave-valor y documentos que escala solo y cobra por uso.
import json
import fakeredis  # en producción: import redis

r = fakeredis.FakeRedis(decode_responses=True)  # en producción: redis.Redis(host=..., decode_responses=True)

consultas_a_la_base = 0


def buscar_en_base(sku):
    """Simula la consulta cara a la base principal (joins, precios, inventario)."""
    global consultas_a_la_base
    consultas_a_la_base += 1
    return {"sku": sku, "nombre": f"Producto {sku}", "precio": 899}


def obtener_producto(sku):
    """Cache-aside: primero Redis; si no está, la base, y se guarda 5 minutos."""
    clave = f"producto:{sku}"
    en_cache = r.get(clave)
    if en_cache is not None:
        return json.loads(en_cache)
    producto = buscar_en_base(sku)
    r.set(clave, json.dumps(producto), ex=300)  # expira en 300 segundos
    return producto


for sku in ["A1", "A1", "B2", "A1", "A1", "B2", "C3", "A1"]:
    obtener_producto(sku)
print(f"8 visitas, {consultas_a_la_base} consultas a la base")
print("Segundos antes de que expire producto:A1:", r.ttl("producto:A1"))

# Ranking de más vendidos en tiempo real con un sorted set
for sku, unidades in [("A1", 3), ("B2", 1), ("C3", 7), ("A1", 5), ("B2", 2)]:
    r.zincrby("ventas:hoy", unidades, sku)
print("Top 3 del día:", r.zrevrange("ventas:hoy", 0, 2, withscores=True))
8 visitas, 3 consultas a la base
Segundos antes de que expire producto:A1: 300
Top 3 del día: [('A1', 8.0), ('C3', 7.0), ('B2', 3.0)]De ocho visitas, solo tres llegaron a la base principal; el resto las resolvió Redis. El ranking del día se actualiza con cada venta sin recalcular nada. Pero ¿qué tan grande debe ser el caché? Esta simulación usa tráfico realista, donde pocos productos concentran la mayoría de las visitas:
import random
from collections import OrderedDict

random.seed(7)
N_PRODUCTOS = 10_000
VISITAS = 200_000

# Pocos productos concentran la mayoría de las visitas (ley de Zipf, s = 1)
pesos = [1 / k for k in range(1, N_PRODUCTOS + 1)]
visitas = random.choices(range(N_PRODUCTOS), weights=pesos, k=VISITAS)


def tasa_de_aciertos(capacidad):
    """Simula un caché LRU (lo que hace Redis con maxmemory-policy allkeys-lru)."""
    cache, aciertos = OrderedDict(), 0
    for sku in visitas:
        if sku in cache:
            aciertos += 1
            cache.move_to_end(sku)
        else:
            cache[sku] = True
            if len(cache) > capacidad:
                cache.popitem(last=False)
    return aciertos / VISITAS


for pct in (1, 5, 10, 20, 50):
    capacidad = N_PRODUCTOS * pct // 100
    print(f"Caché con el {pct:>2}% del catálogo ({capacidad:>5} productos): "
          f"{tasa_de_aciertos(capacidad):.0%} de las visitas no tocan la base")
Caché con el 1% del catálogo ( 100 productos): 39% de las visitas no tocan la base
Caché con el 5% del catálogo ( 500 productos): 59% de las visitas no tocan la base
Caché con el 10% del catálogo ( 1000 productos): 68% de las visitas no tocan la base
Caché con el 20% del catálogo ( 2000 productos): 77% de las visitas no tocan la base
Caché con el 50% del catálogo ( 5000 productos): 89% de las visitas no tocan la base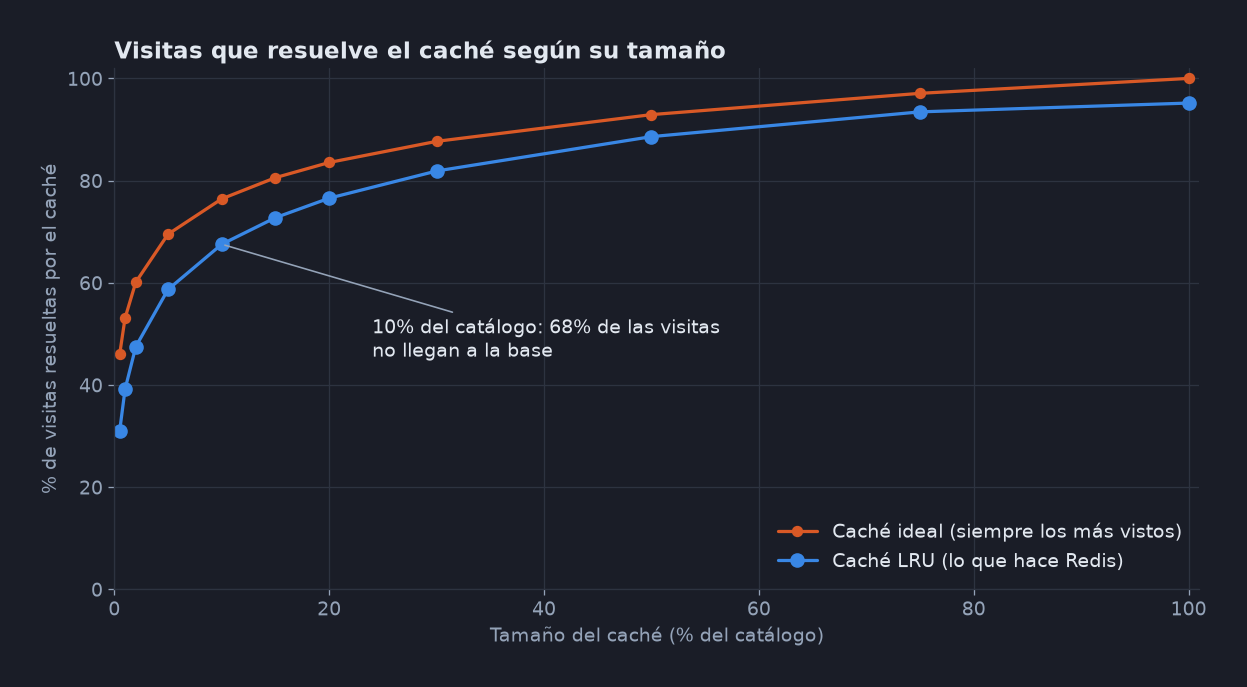
La lección para el presupuesto: no necesitas meter todo el catálogo en memoria. Un caché del 10% absorbe dos tercios del tráfico y duplicarlo agrega menos de diez puntos. Ese es el tipo de análisis que justifica cuánta memoria pagar.
Columnas anchas: Cassandra y ScyllaDB
Están diseñadas para escribir volúmenes enormes de datos distribuidos en muchos servidores y regiones, sin un nodo maestro que se vuelva cuello de botella. Son la opción para telemetría de dispositivos IoT, eventos de apps, historial de mensajes y registros de actividad. El precio: modelas una tabla por cada consulta que necesitas, no hay JOIN y operarlas requiere experiencia.
Grafos: Neo4j
Tratan las relaciones como datos de primera clase. Responder "clientes que comparten tarjeta, dirección o dispositivo con una cuenta marcada como fraude, a tres saltos de distancia" es trivial en una base de grafos y muy costoso con JOIN encadenados. Brillan en detección de fraude, recomendaciones, redes sociales y análisis de dependencias.
Tip: existen bases especializadas fuera de estas cuatro familias. Para búsqueda de texto con filtros está OpenSearch o Elasticsearch; para series de tiempo, TimescaleDB o InfluxDB; y para búsqueda semántica con IA, extensiones como pgvector sobre PostgreSQL. Elige por el problema, no por la moda.
Tecnologías: pros y contras
Relacionales
| Tecnología | Úsala para | Pros | Contras |
|---|---|---|---|
| PostgreSQL | La base principal de casi cualquier producto | ACID, SQL completo, JSONB, extensiones (PostGIS, pgvector, TimescaleDB), open source | Escalar escrituras en varios servidores requiere particionar o herramientas como Citus; necesita afinación y mantenimiento |
| MySQL / MariaDB | Aplicaciones web, e-commerce, CMS | Muy extendida, rápida en lecturas simples, hosting barato y mucha experiencia en el mercado | Menos funciones avanzadas que PostgreSQL; MySQL pertenece a Oracle y MariaDB es un fork con diferencias |
| SQLite | Apps móviles, de escritorio, prototipos, análisis local | Cero servidor, un solo archivo, viene en Python y en cada teléfono | Una sola escritura a la vez; no es para muchos usuarios escribiendo en paralelo |
| SQL Server / Oracle | Corporativos con ecosistema Microsoft u Oracle | Soporte comercial, herramientas maduras de administración y BI | Licencias caras y dependencia del proveedor |
No relacionales
| Tecnología | Úsala para | Pros | Contras |
|---|---|---|---|
| MongoDB | Catálogos, perfiles, contenido con estructura variable | Esquema flexible, lectura de un documento completo, escala horizontal con sharding, transacciones multidocumento | Los JOIN ($lookup) son limitados; si no validas el esquema, los datos se ensucian; licencia SSPL, que la OSI no reconoce como open source |
| Redis / Valkey | Caché, sesiones, carrito, rankings, colas ligeras | Latencia de menos de un milisegundo, estructuras útiles (listas, sets ordenados, streams) | La memoria es cara; no es base principal. Redis cambió su licencia y Valkey es el fork con licencia BSD |
| DynamoDB | Apps en AWS con tráfico impredecible | Administrada, escala sola, pago por uso, latencia de milisegundos | Hay que diseñar todo por patrones de acceso; consultas ad hoc difíciles; dependencia de AWS; el costo crece con el tráfico |
| Cassandra / ScyllaDB | IoT, eventos, mensajería a gran escala | Escrituras masivas, multirregión, sin punto único de falla | Una tabla por consulta, sin JOIN, operación compleja, consistencia ajustable que hay que entender |
| Neo4j | Fraude, recomendaciones, redes | Consultas de muchos saltos simples y rápidas con Cypher | Nicho; el clúster es de la edición comercial; no sustituye a tu base transaccional |
| OpenSearch / Elasticsearch | Búsqueda en el catálogo, logs | Búsqueda de texto, relevancia, filtros y facetas | No es base principal; consume mucha memoria; hay que sincronizarla con la fuente de verdad |
Qué base usar según el caso de negocio
| Caso de negocio | Recomendación | Por qué |
|---|---|---|
| Pagos, facturación, saldos | PostgreSQL | ACID: nada queda a medias |
| Pedidos e inventario | PostgreSQL o MySQL | Reglas de integridad y reportes con JOIN |
| Catálogo con atributos variables | PostgreSQL con JSONB, o MongoDB | Flexibilidad sin perder consultas |
| Sesiones, carrito, caché | Redis o Valkey | Velocidad y expiración automática |
| Rankings y contadores en vivo | Redis o Valkey | Sets ordenados que se actualizan en cada evento |
| Telemetría de dispositivos | Cassandra, ScyllaDB o TimescaleDB | Escrituras masivas ordenadas por tiempo |
| Fraude y recomendaciones | Neo4j | Relaciones de muchos saltos |
| Buscador del sitio | OpenSearch | Relevancia, sinónimos y filtros |
| Reportes y BI | BigQuery, ClickHouse o DuckDB | Bases columnares hechas para analizar millones de filas |
| Búsqueda semántica con IA | PostgreSQL con pgvector | Vectores junto a tus datos, sin otro sistema |
Lo mejor de dos mundos: relacional con JSON
Muchas veces la flexibilidad que buscas en MongoDB ya la tienes en PostgreSQL con columnas JSONB: columnas fijas para lo que todo registro tiene y JSON para lo que varía, con índices y consultas SQL normales. El mismo patrón funciona en SQLite:
import json
import sqlite3

con = sqlite3.connect(":memory:")
# Columnas fijas para lo que todo producto tiene; JSON para lo que varía
con.execute("""
CREATE TABLE productos (
    sku       TEXT PRIMARY KEY,
    tipo      TEXT NOT NULL,
    precio    REAL NOT NULL CHECK (precio > 0),
    atributos TEXT NOT NULL CHECK (json_valid(atributos))
)""")
con.executemany("INSERT INTO productos VALUES (?, ?, ?, ?)", [
    ("LAP-01", "laptop", 18999, json.dumps({"ram_gb": 16, "cpu": "Ryzen 7"})),
    ("LAP-02", "laptop", 12999, json.dumps({"ram_gb": 8, "cpu": "Core i5"})),
    ("PLA-01", "playera", 349, json.dumps({"talla": "M", "color": "negro"})),
])

# Consultas SQL normales sobre los atributos flexibles
filas = con.execute("""
    SELECT sku, json_extract(atributos, '$.cpu')
    FROM productos
    WHERE tipo = 'laptop' AND json_extract(atributos, '$.ram_gb') >= 16
""").fetchall()
print("Laptops con 16 GB o más:", filas)

# Y sigues teniendo reglas: la base rechaza un precio inválido
try:
    con.execute("INSERT INTO productos VALUES ('X', 'libro', -5, '{}')")
except sqlite3.IntegrityError as e:
    print("Rechazado:", e)
Laptops con 16 GB o más: [('LAP-01', 'Ryzen 7')]
Rechazado: CHECK constraint failed: precio > 0Obtienes el catálogo flexible del ejemplo de MongoDB sin perder las reglas de integridad ni los JOIN con pedidos y clientes. En la práctica, las empresas combinan varias bases, cada una para lo que hace mejor. A esto se le llama persistencia políglota:
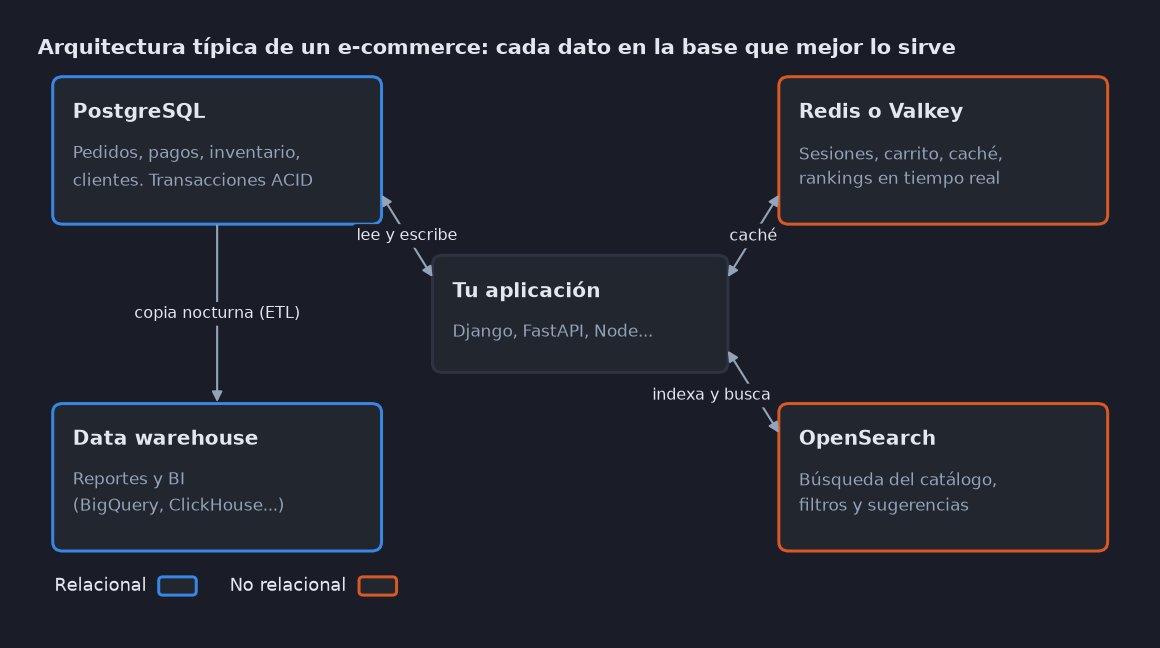
Ojo con el costo: cada base extra es un sistema más que respaldar, monitorear, asegurar y mantener sincronizado. Agrega una solo cuando el problema que resuelve ya te está costando.
Tres mitos sobre SQL y NoSQL
- "NoSQL escala y SQL no." Un solo servidor de PostgreSQL bien configurado atiende a la gran mayoría de los negocios, y crece con réplicas de lectura y particionamiento. Para escala global existen bases SQL distribuidas como CockroachDB, YugabyteDB o Citus.
- "NoSQL no tiene esquema." El esquema siempre existe; en NoSQL se muda de la base a tu código. Si nadie lo valida, cada versión de tu app escribe documentos distintos. MongoDB permite validar con JSON Schema: úsalo.
- "NoSQL no tiene transacciones." MongoDB y DynamoDB ya ofrecen transacciones que abarcan varios documentos o elementos. Lo que cambia es el costo y los límites, no la posibilidad.
Cómo decidir en cinco preguntas
- ¿Un error en este dato cuesta dinero? Usa una base relacional.
- ¿Vas a cruzar información de formas que hoy no conoces? Relacional: SQL responde preguntas nuevas sin rediseñar.
- ¿Tus consultas son pocas, conocidas y enormes en volumen? Considera NoSQL, modelado para esas consultas.
- ¿La estructura cambia mucho entre registros? Prueba primero JSONB en PostgreSQL; si no alcanza, una base de documentos.
- ¿Tu equipo sabe operarla? La mejor base es la que puedes respaldar, monitorear y restaurar a las tres de la mañana.
Tip: si estás empezando un producto y no sabes qué elegir, empieza con PostgreSQL. Agrega Redis cuando necesites velocidad y una base especializada cuando un problema concreto lo justifique.
Conclusión
La comparación de bases de datos relacionales vs no relacionales no tiene un ganador: tiene casos de uso. Los puntos clave:
- Relacionales (PostgreSQL, MySQL, SQLite) para datos donde la integridad importa y para reportes que cruzan información: pagos, pedidos, inventario, clientes.
- Documentos (MongoDB) para estructuras variables que se leen completas, como catálogos y perfiles, cuidando la duplicación de datos.
- Clave-valor (Redis, Valkey, DynamoDB) para velocidad: caché, sesiones y rankings. Un caché del 10% del catálogo puede absorber dos tercios del tráfico.
- Columnas anchas y grafos para problemas específicos: escrituras masivas y relaciones de muchos saltos.
- La arquitectura más común combina PostgreSQL como fuente de verdad con bases especializadas donde aportan, y cada base extra debe justificar su costo operativo.
El siguiente paso: toma tu proyecto actual, lista las cinco consultas más importantes y el costo de que cada dato quede mal. Esa lista te dirá qué base usar mejor que cualquier comparativa.