Cada trimestre alguien en tu empresa decide cuánto dinero va a TV, cuánto a Meta y cuánto a Google. Casi siempre la decisión se basa en lo que reporta cada plataforma, y cada plataforma se atribuye más ventas de las que realmente genera. A eso súmale que la TV no tiene clics, que las cookies de terceros están desapareciendo y que iOS bloquea buena parte del rastreo. El resultado es que no sabes qué canal vende y cuál solo se lleva el crédito.
El Marketing Mix Modeling (MMM) resuelve ese problema sin rastrear a nadie: usa solo datos agregados, como ventas e inversión por semana, y estima cuánto aporta cada canal. En este artículo vas a construir un MMM bayesiano con PyMC-Marketing, medir el retorno (ROAS) de cada canal con su incertidumbre y usar el modelo para repartir el presupuesto del siguiente trimestre. Todo el código corre en tu computadora en menos de un minuto.
Qué es un Marketing Mix Modeling
Un MMM es una regresión sobre series de tiempo. Explica las ventas de cada semana como la suma de una base (lo que venderías sin publicidad: tendencia, temporada, fechas especiales) más el efecto de cada canal de medios:
\[ y_t = \beta_0 + \sum_{c} \beta_c \, f\big(\text{adstock}(x_{c,t})\big) + \sum_{k} \gamma_k \, z_{k,t} + \varepsilon_t \]Aquí \( y_t \) son las ventas de la semana \( t \), \( x_{c,t} \) la inversión en el canal \( c \), \( z_{k,t} \) las variables de control (por ejemplo, una semana de Buen Fin) y \( \beta_c \) el tamaño del efecto de cada canal. Lo que distingue a un MMM de una regresión lineal cualquiera son dos transformaciones que reflejan cómo funciona la publicidad en la vida real: el arrastre y la saturación.
Arrastre (adstock)
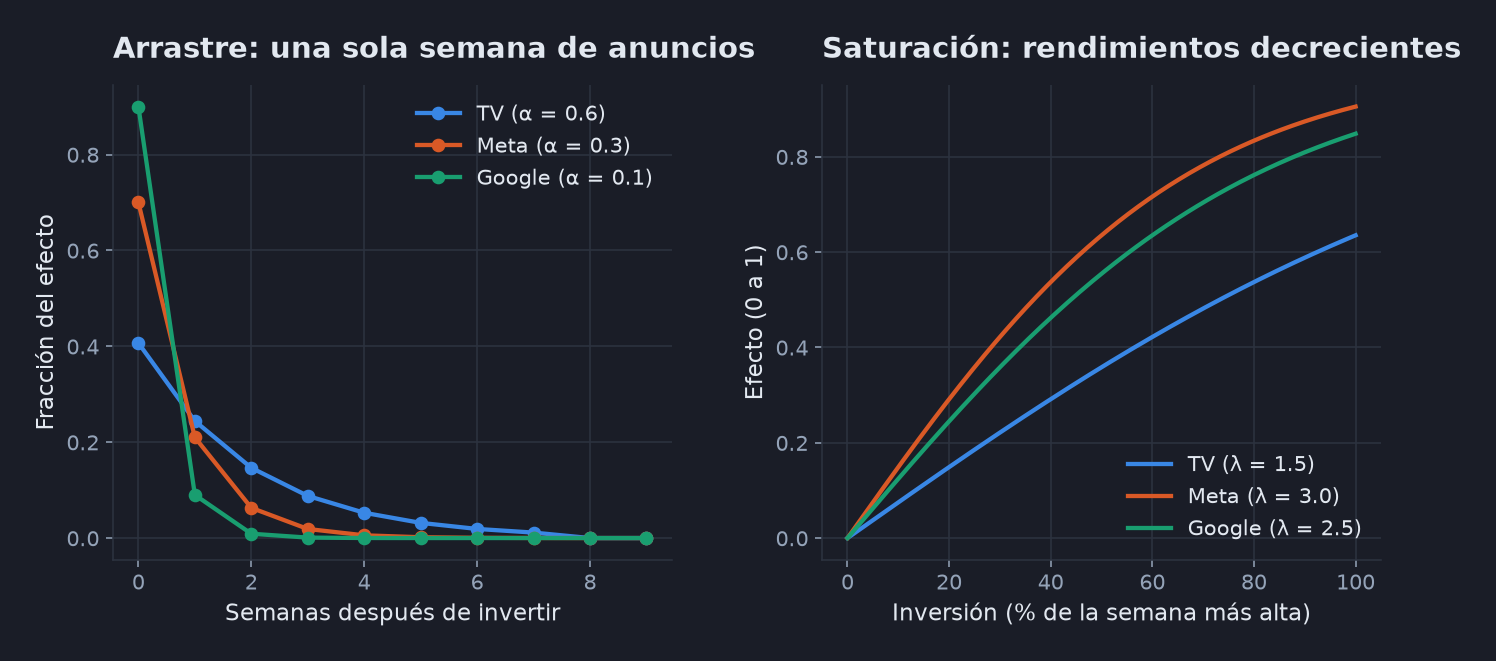
Un anuncio de TV que ves el lunes puede influir en lo que compras dos semanas después. El adstock geométrico modela ese arrastre: cada semana conserva una fracción \( \alpha \) del efecto de la anterior.
\[ \text{adstock}(x_t) = \frac{\sum_{l=0}^{L-1} \alpha^{l} \, x_{t-l}}{\sum_{l=0}^{L-1} \alpha^{l}} \]Con \( \alpha \) cercano a 0, el efecto ocurre la misma semana (típico de búsqueda pagada). Con \( \alpha \) alto, el efecto se reparte en varias semanas (típico de TV). El denominador normaliza los pesos para que el arrastre redistribuya el efecto en el tiempo sin inflarlo.
Saturación
Duplicar la inversión en un canal no duplica las ventas: llega un punto en que ya le mostraste el anuncio a casi todos los que podían comprar. La saturación logística captura esos rendimientos decrecientes:
\[ f(x) = \frac{1 - e^{-\lambda x}}{1 + e^{-\lambda x}} \]Un \( \lambda \) alto significa que el canal se satura rápido. Esta curva es la que después le permite al modelo decir dónde rinde más el siguiente peso que inviertas.
Instala PyMC-Marketing
Necesitas Python 3.12 o más reciente. nutpie es un sampler escrito en Rust que acelera mucho el ajuste y, junto con numba, evita depender de un compilador de C (algo que en Windows ahorra muchos dolores de cabeza):
pip install "pymc-marketing==1.2.0" "nutpie==0.16.11" "numba==0.67.0"Los datos: dos años de ventas semanales
Para saber si el modelo funciona necesitas comparar lo que estima contra la verdad, y con datos reales nunca conoces la verdad. Por eso vas a simular una tienda en línea mexicana con 104 semanas de datos, en miles de pesos: tres canales con efectos que tú defines, una tendencia de crecimiento, temporada anual y el Buen Fin. Las funciones de adstock y saturación del código son exactamente las que usa PyMC-Marketing por dentro:
import numpy as np
import pandas as pd


def adstock_geometrico(x, alpha, l_max=8):
    """Cada semana arrastra una fracción alpha del efecto de la anterior."""
    pesos = alpha ** np.arange(l_max)
    pesos = pesos / pesos.sum()  # normalizado: el efecto total no cambia, se reparte
    return np.convolve(x, pesos)[: len(x)]


def saturacion_logistica(x, lam):
    """Rendimientos decrecientes: crece casi lineal y luego se aplana."""
    return (1 - np.exp(-lam * x)) / (1 + np.exp(-lam * x))


rng = np.random.default_rng(42)

# 2 años de datos semanales
fechas = pd.date_range("2024-01-07", periods=104, freq="W-SUN")
n = len(fechas)

# Inversión semanal por canal (miles de MXN)
tv = np.where(rng.random(n) < 0.35, rng.uniform(80, 160, n), 0.0)  # campañas por bloques
meta = rng.uniform(5, 60, n)
google = np.where(rng.random(n) < 0.2, 0.0, rng.uniform(5, 50, n))  # ~20% de semanas en pausa

# Efecto real de cada canal: arrastre (alpha), saturación (lam) y tamaño (beta)
reales = {
    "tv":     {"alpha": 0.6, "lam": 1.5, "beta": 300.0},
    "meta":   {"alpha": 0.3, "lam": 3.0, "beta": 220.0},
    "google": {"alpha": 0.1, "lam": 2.5, "beta": 150.0},
}
inversion = {"tv": tv, "meta": meta, "google": google}

contribucion_real = {}
for canal, p in reales.items():
    x = inversion[canal] / inversion[canal].max()  # escala 0-1, como el modelo
    x_sat = saturacion_logistica(adstock_geometrico(x, p["alpha"]), p["lam"])
    contribucion_real[canal] = p["beta"] * x_sat

# Base: tendencia + estacionalidad anual + Buen Fin (noviembre)
t = np.arange(n)
buen_fin = ((fechas.month == 11) & (fechas.day >= 14) & (fechas.day <= 21)).astype(float)
base = 400 + 1.0 * t + 40 * np.sin(2 * np.pi * t / 52.18) + 150 * buen_fin

ventas = base + sum(contribucion_real.values()) + rng.normal(0, 25, n)

df = pd.DataFrame({
    "fecha": fechas, "tv": tv, "meta": meta, "google": google,
    "buen_fin": buen_fin, "t": t, "ventas": ventas,
})
print(df.head().to_string(index=False, float_format="%.1f"))
print(f"\nSemanas: {n} | Ventas totales: {df.ventas.sum():,.0f} mil MXN")
fecha tv meta google buen_fin t ventas
2024-01-07 0.0 11.7 11.4 0.0 0 446.3
2024-01-14 0.0 32.8 40.0 0.0 1 675.8
2024-01-21 0.0 43.2 13.9 0.0 2 656.8
2024-01-28 0.0 37.0 46.0 0.0 3 681.5
2024-02-04 87.7 16.0 34.5 0.0 4 655.7
Semanas: 104 | Ventas totales: 74,007 mil MXNFíjate en dos decisiones del simulador que importan en datos reales. La TV invierte por bloques (hay semanas en cero) y Google tiene alrededor de 20% de semanas en pausa. Esa variación es la que permite al modelo separar el efecto de cada canal: si inviertes exactamente lo mismo todas las semanas, ningún modelo puede saber qué pasaría si invirtieras distinto.
Tip: para un MMM confiable necesitas al menos dos años de datos semanales y que la inversión de cada canal varíe con el tiempo. Si tus campañas siempre corren igual, programa semanas con más y con menos inversión antes de modelar.
Ajusta el modelo con PyMC-Marketing
La clase MMM arma el modelo completo: le dices qué columna es la fecha, cuál es la venta, qué columnas son canales y cuáles son controles. Como no le das todos los priors, usa valores razonables por defecto; el único que conviene ajustar es el del tamaño del efecto, proporcional a lo que inviertes en cada canal (así el modelo empieza suponiendo que donde más gastas, más efecto podría haber, pero los datos deciden):
import arviz as az
import pandas as pd
from pymc_extras.prior import Prior
from pymc_marketing.mmm import MMM, GeometricAdstock, LogisticSaturation

canales = ["tv", "meta", "google"]
X = df[["fecha", *canales, "buen_fin", "t"]]
y = df["ventas"]

# Prior del tamaño del efecto proporcional a lo que se invierte en cada canal
participacion = X[canales].sum() / X[canales].sum().sum()
priors = {
    "saturation_beta": Prior(
        "HalfNormal", sigma=(len(canales) * participacion).to_numpy(), dims="channel"
    ),
}

mmm = MMM(
    date_column="fecha",
    target_column="ventas",
    channel_columns=canales,
    control_columns=["buen_fin", "t"],  # Buen Fin y tendencia
    adstock=GeometricAdstock(l_max=8),  # arrastre de hasta 8 semanas
    saturation=LogisticSaturation(),
    yearly_seasonality=2,  # estacionalidad anual con 2 pares de Fourier
    model_config=priors,
    sampler_config={
        "draws": 1_000, "tune": 1_500, "chains": 4, "target_accept": 0.95,
        "nuts_sampler": "nutpie", "compile_kwargs": {"mode": "NUMBA"},
    },
)
mmm.build_model(X, y)
# Guarda la contribución de cada canal en miles de MXN, no en la escala interna
mmm.add_original_scale_contribution_variable(var=["channel_contribution"])
idata = mmm.fit(X, y, random_seed=42)

pd.set_option("display.width", 120)
resumen = az.summary(idata, var_names=["adstock_alpha", "saturation_lam"], round_to=2)
print(resumen[["mean", "sd", "eti89_lb", "eti89_ub", "r_hat"]])
print("Divergencias:", int(idata.sample_stats["diverging"].sum()))
mean sd eti89_lb eti89_ub r_hat
adstock_alpha[tv] 0.63 0.04 0.56 0.69 1.00
adstock_alpha[meta] 0.33 0.05 0.25 0.41 1.00
adstock_alpha[google] 0.05 0.04 0.00 0.12 1.00
saturation_lam[tv] 1.70 0.73 0.62 2.95 1.00
saturation_lam[meta] 2.78 0.69 1.63 3.83 1.00
saturation_lam[google] 2.65 0.85 1.25 4.03 1.01
Divergencias: 0Antes de interpretar cualquier número revisa el diagnóstico. Todas las cadenas convergen (r_hat entre 1.00 y 1.01) y no hay divergencias, así que el muestreo es confiable. Las columnas eti89 son el intervalo creíble del 89%, el que ArviZ 1.x muestra por defecto.
Ahora compara contra la verdad. El arrastre de TV sale en 0.63 (real: 0.6), el de Meta en 0.33 (real: 0.3) y el de Google en 0.05 (real: 0.1). Los tres valores reales caen dentro de sus intervalos. Los parámetros de saturación tienen intervalos más anchos, y es normal: con dos años de datos hay muchas combinaciones de saturación y tamaño de efecto que explican casi igual las ventas. Lo que sí queda bien determinado es lo que te importa para decidir: cuánto vende cada canal.
ROAS: cuánto vende cada peso invertido
El ROAS (return on ad spend) es la contribución de un canal dividida entre lo que invertiste en él. Como el modelo es bayesiano, no obtienes un solo ROAS sino una distribución: calculas el ROAS en cada una de las 4,000 muestras del posterior y de ahí sacas la media y un intervalo:
# Contribución total de cada canal (miles de MXN), por muestra del posterior
contrib = idata.posterior["channel_contribution_original_scale"].sum("date")
gasto = X[canales].sum()

filas = []
for canal in canales:
    roas = contrib.sel(channel=canal) / gasto[canal]  # ventas por cada peso invertido
    filas.append({
        "canal": canal,
        "gasto": gasto[canal],
        "contribucion": float(contrib.sel(channel=canal).mean()),
        "roas": float(roas.mean()),
        "roas_5%": float(roas.quantile(0.05)),
        "roas_95%": float(roas.quantile(0.95)),
        "roas_real": contribucion_real[canal].sum() / gasto[canal],
    })
tabla = pd.DataFrame(filas).set_index("canal")
print(tabla.round(2))
gasto contribucion roas roas_5% roas_95% roas_real
canal
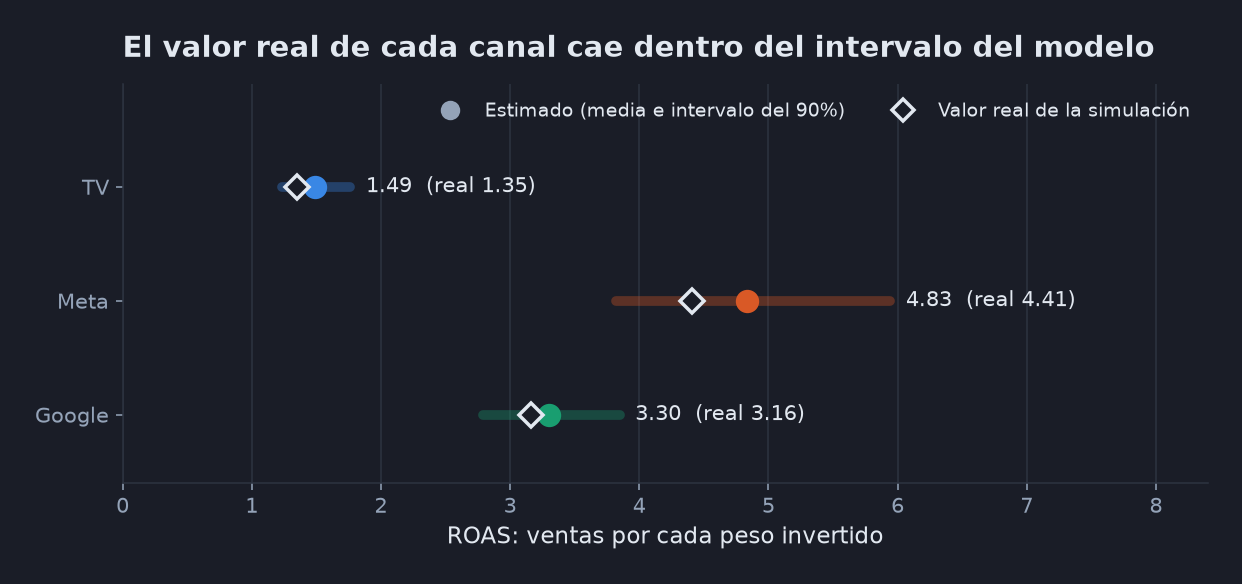
tv 4071.85 6058.46 1.49 1.23 1.76 1.35
meta 3236.18 15633.60 4.83 3.82 5.94 4.41
google 2281.37 7525.04 3.30 2.79 3.85 3.16La columna roas_real solo existe porque simulaste los datos; con tus datos reales no la tendrás, y por eso este ejercicio es tan útil para confiar en el método. Meta es el canal más eficiente (4.83 pesos de venta por peso invertido), seguido de Google (3.30) y TV (1.49). En los tres casos el valor real cae dentro del intervalo del 90%.
Ojo con leer el ROAS como ganancia. Un ROAS de 1.49 significa que cada peso en TV genera 1.49 pesos de venta, no de utilidad. Si tu margen es de 30%, cada peso en TV te regresa unos 45 centavos de utilidad: estás perdiendo dinero en ese canal aunque "venda".
Descomposición: qué parte de las ventas viene de la publicidad
La otra pregunta que el MMM responde es cuánto venderías sin publicidad. El método compute_mean_contributions_over_time regresa la contribución de cada componente semana a semana:
# Contribución media de cada componente, semana a semana (miles de MXN)
aportes = mmm.compute_mean_contributions_over_time()
base = aportes[["intercept", "yearly_seasonality", "t", "buen_fin"]].sum(axis=1)

total = aportes[canales].sum().sum() + base.sum()
print(f"Base (sin publicidad): {base.sum():>9,.0f}  ({base.sum() / total:.0%})")
for canal in canales:
    print(f"{canal:<21} {aportes[canal].sum():>9,.0f}  ({aportes[canal].sum() / total:.0%})")
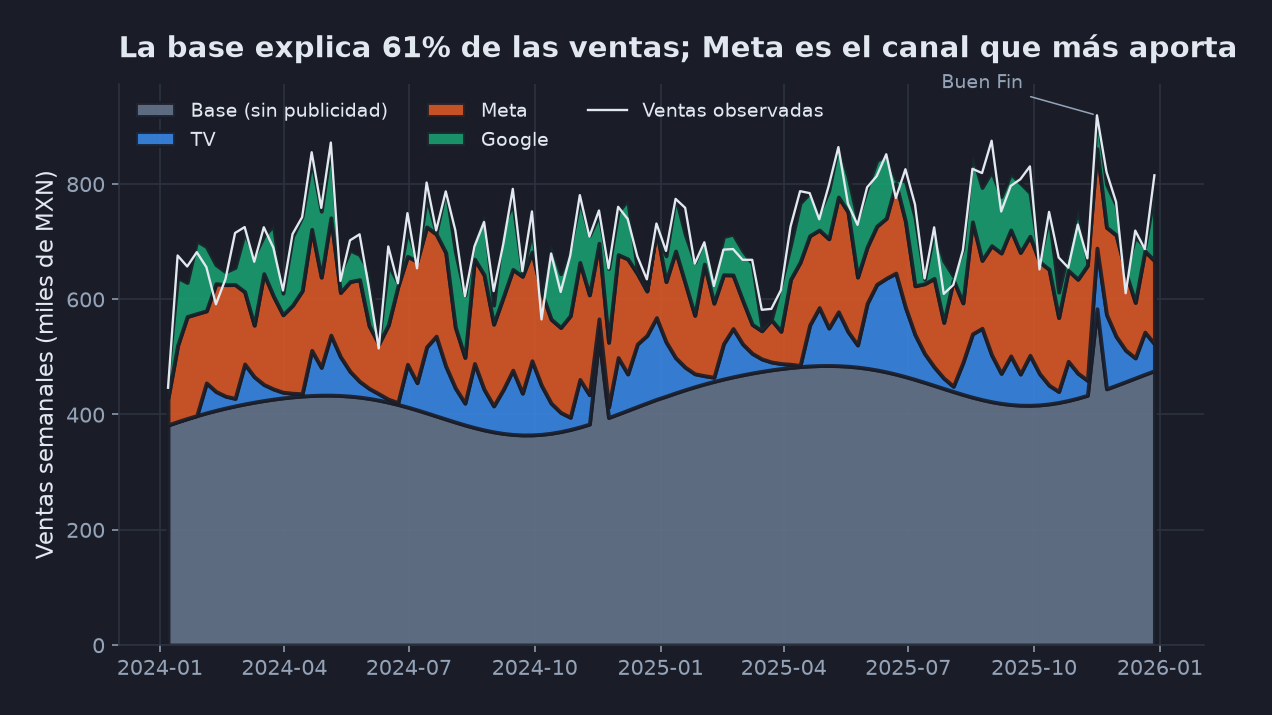
Base (sin publicidad): 44,788 (61%)
tv 6,058 (8%)
meta 15,634 (21%)
google 7,525 (10%)El 61% de las ventas es la base: clientes que compran por la marca, la temporada o el Buen Fin, sin importar los anuncios. El otro 39% lo generan los medios, y Meta aporta más del doble que la TV aunque recibe menos presupuesto. Las cuatro partes suman lo que el modelo predice para cada semana, por eso puedes graficarlas apiladas:
Optimiza el presupuesto del siguiente trimestre
Saber el ROAS promedio no basta para reasignar dinero. Lo que importa es el rendimiento marginal: cuánto vende el siguiente peso en cada canal. Un canal con ROAS alto puede estar ya saturado, y uno con ROAS bajo puede tener espacio para crecer. El optimizador de PyMC-Marketing usa las curvas de saturación y arrastre para encontrar el reparto que maximiza las ventas esperadas, sin cambiar el presupuesto total:
import xarray as xr

# Próximo trimestre: 13 semanas con el mismo presupuesto semanal de hoy
semanal = X[canales].mean()
optimizador = mmm.budget_optimizer(start_date="2026-01-04", end_date="2026-03-29")

# Cada canal puede bajar a la mitad o subir al doble de su inversión actual
limites = {c: (0.5 * semanal[c], 2.0 * semanal[c]) for c in canales}
resultado = optimizador.allocate_budget(total_budget=semanal.sum(), budget_bounds=limites)

actual = xr.DataArray(semanal.to_numpy(), dims="channel", coords={"channel": canales})
venta_actual = optimizador.evaluate_response_distribution(actual)
venta_optima = optimizador.evaluate_response_distribution(resultado.budgets)

print("Inversión semanal (miles de MXN):")
for canal in canales:
    print(f"  {canal:<7} actual {semanal[canal]:5.1f}  ->  óptima {float(resultado.budgets.sel(channel=canal)):5.1f}")
ganancia = venta_optima - venta_actual  # una ganancia por cada muestra del posterior
print(f"Ganancia esperada en el trimestre: {float(ganancia.mean()):,.0f} mil MXN "
      f"(90%: {float(ganancia.quantile(0.05)):,.0f} a {float(ganancia.quantile(0.95)):,.0f})")
print(f"El plan óptimo vende más en {int((ganancia > 0).sum()):,} de {ganancia.size:,} muestras del posterior")
Inversión semanal (miles de MXN):
tv actual 39.2 -> óptima 19.6
meta actual 31.1 -> óptima 45.1
google actual 21.9 -> óptima 27.5
Ganancia esperada en el trimestre: 349 mil MXN (90%: 198 a 503)
El plan óptimo vende más en 3,999 de 4,000 muestras del posteriorCon el mismo presupuesto semanal (92.2 mil pesos), el modelo recomienda bajar la TV a la mitad y repartir ese dinero entre Meta y Google. La TV queda justo en el límite inferior que pusiste; sin ese límite el optimizador la bajaría todavía más. Los límites existen porque en la vida real no puedes apagar un canal de golpe: hay contratos, compras de espacio anticipadas y efectos de marca que el modelo no ve.
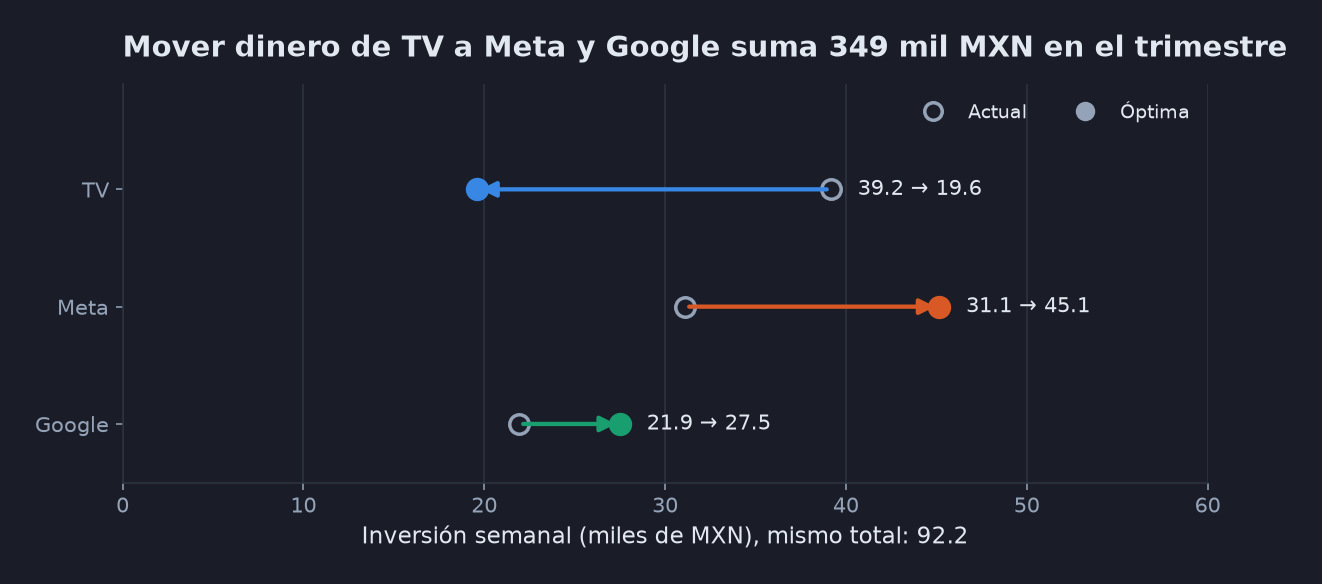
La ganancia esperada es de 349 mil pesos en el trimestre, con un intervalo del 90% entre 198 y 503 mil. Como los datos son simulados, puedes comprobarlo: con los parámetros reales, la ganancia de este reparto es de 310 mil pesos, dentro del intervalo del modelo. Y como evaluaste los dos planes con todo el posterior, también sabes que el plan nuevo vende más que el actual en 3,999 de las 4,000 muestras.
Lo que un MMM no te dice
Un MMM es una herramienta poderosa, pero tiene límites que debes conocer antes de mover presupuesto real:
- Canales que se mueven juntos. Si subes Meta y Google al mismo tiempo, o si tu inversión en Google siempre sigue a la temporada alta, el modelo no puede separar sus efectos. Verás intervalos de ROAS enormes. La solución es variar la inversión de forma independiente por canal.
- Correlación no es causalidad. El MMM aprende de datos históricos. Si históricamente subías la inversión justo cuando la demanda ya iba a subir, el modelo le dará crédito de más a la publicidad. Los experimentos de incrementalidad (lift tests, geo experimentos) son la mejor forma de calibrarlo; PyMC-Marketing los incorpora con
add_lift_test_measurements. - Los priors importan. Con pocos datos, el prior influye en el resultado. Documenta los que usas y prueba si tus conclusiones cambian con priors razonables distintos.
- Valida fuera de muestra. Un buen ajuste histórico no garantiza buenos pronósticos.
TimeSliceCrossValidatorentrena el modelo en un periodo y lo evalúa en el siguiente.
| Método | Qué mide | Fortaleza | Debilidad |
|---|---|---|---|
| Atribución por clic | Quién tocó al usuario antes de comprar | Detalle por campaña, en tiempo real | No ve TV ni efectos sin clic; depende de cookies |
| Marketing Mix Modeling | Efecto incremental de cada canal sobre las ventas | Funciona con datos agregados; incluye todos los canales | Necesita historia y variación; no es causal por sí solo |
| Experimentos de incrementalidad | Efecto causal de un canal en un periodo | La evidencia más fuerte | Caros y lentos; miden un canal a la vez |
Los equipos más maduros combinan los tres: el MMM para la visión completa y la planeación, los experimentos para calibrarlo y la atribución por clic para optimizar campañas dentro de cada canal.
Conclusión
Con PyMC-Marketing construiste un Marketing Mix Modeling bayesiano completo: simulaste datos con efectos conocidos, ajustaste el modelo en menos de un minuto con nutpie, verificaste que recupera el arrastre y el ROAS reales de cada canal, separaste las ventas base de las que genera la publicidad y encontraste un reparto del mismo presupuesto que vende 349 mil pesos más en un trimestre.
La diferencia con un reporte de plataforma es que cada número viene con su incertidumbre, y eso cambia la conversación: en lugar de "Meta tiene ROAS de 4.83", puedes decir "Meta genera entre 3.82 y 5.94 pesos por peso invertido, y pasar 19.6 mil pesos semanales de TV a Meta y Google vende más en casi todos los escenarios que el modelo considera posibles". Antes de aplicarlo a tus datos, empieza por lo mismo que hiciste aquí: simula un escenario con tus canales, comprueba que el modelo recupera lo que pusiste y después confía en lo que te diga sobre tu negocio.