Casi todo lo que mides en el mundo real llega como una onda: la voz que capta un micrófono, la señal de radio que recibe tu teléfono, la vibración de un motor o el volumen diario de una acción en la bolsa. Entender ondas en Python significa poder descomponer esas señales, ver qué frecuencias las forman y tomar decisiones con esa información.
En este artículo vas a construir la teoría desde cero (amplitud, frecuencia, fase, muestreo y el teorema de Nyquist) y después la vas a aplicar a tres casos reales: análisis de voz para evaluar la pronunciación de vocales, modulación AM y FM como la usan las radios, y la transformada de Fourier para buscar ciclos en series financieras sin engañarte con ruido. Todo el código usa NumPy y SciPy y lo puedes correr tal cual.
Qué es una onda y cómo vive en una computadora
Una onda es una magnitud que se repite en el tiempo. La más simple es la senoidal, y es la pieza con la que se construye todo lo demás:
\[ x(t) = A \sin(2\pi f t + \varphi) \]Cada parámetro tiene un significado físico directo:
| Parámetro | Símbolo | Qué controla | Ejemplo en audio |
|---|---|---|---|
| Amplitud | \( A \) | Qué tan grande es la oscilación | El volumen |
| Frecuencia | \( f \) | Cuántos ciclos completa por segundo (Hz) | El tono: 440 Hz es la nota La |
| Fase | \( \varphi \) | En qué punto del ciclo empieza | El desfase entre dos micrófonos |
| Periodo | \( T = 1/f \) | Cuánto dura un ciclo | 2.27 ms para 440 Hz |
Muestreo: de una curva continua a un arreglo de NumPy
Una computadora no guarda curvas continuas: guarda muestras tomadas a intervalos regulares. La frecuencia de muestreo \( f_s \) dice cuántas muestras tomas por segundo. Con \( f_s = 8000 \) Hz (la calidad de una llamada telefónica), un tono de 440 Hz queda representado por unas 18 muestras por ciclo:
import numpy as np

fs = 8_000                         # frecuencia de muestreo: muestras por segundo (Hz)
t = np.arange(0, 0.01, 1 / fs)     # 10 ms de tiempo discreto

A, f, fase = 0.8, 440, np.pi / 4   # amplitud, frecuencia (Hz) y fase (rad)
x = A * np.sin(2 * np.pi * f * t + fase)

print(f"Muestras en 10 ms: {t.size}")
print(f"Periodo: {1000 / f:.3f} ms = {fs / f:.2f} muestras")
print(f"Primeras 4 muestras: {np.round(x[:4], 4)}")


def frecuencia_dominante(x, fs):
    """Frecuencia (Hz) del pico más alto del espectro."""
    espectro = np.abs(np.fft.rfft(x))
    freqs = np.fft.rfftfreq(x.size, d=1 / fs)
    return freqs[np.argmax(espectro)]


t1 = np.arange(0, 1, 1 / fs)       # 1 segundo
for f_real in (1_000, 3_900, 7_000):
    tono = np.sin(2 * np.pi * f_real * t1)
    vista = frecuencia_dominante(tono, fs)
    print(f"Tono de {f_real:>5} Hz muestreado a {fs} Hz -> se ve como {vista:,.0f} Hz")
Muestras en 10 ms: 80
Periodo: 2.273 ms = 18.18 muestras
Primeras 4 muestras: [0.5657 0.7239 0.7964 0.7749]
Tono de 1000 Hz muestreado a 8000 Hz -> se ve como 1,000 Hz
Tono de 3900 Hz muestreado a 8000 Hz -> se ve como 3,900 Hz
Tono de 7000 Hz muestreado a 8000 Hz -> se ve como 1,000 HzLas tres últimas líneas son la lección más importante del procesamiento digital. El tono de 7,000 Hz no aparece como 7,000 Hz: aparece como 1,000 Hz. Es un alias, una frecuencia falsa que el muestreo inventa.
El teorema de Nyquist y el aliasing
El teorema de muestreo de Nyquist y Shannon dice que solo puedes representar sin ambigüedad frecuencias menores a la mitad de la frecuencia de muestreo:
\[ f_{\max} < \frac{f_s}{2} \]Esa mitad se llama frecuencia de Nyquist. Con \( f_s = 8000 \) Hz el límite es 4,000 Hz, por eso el tono de 3,900 Hz se ve bien y el de 7,000 Hz se "dobla" a \( 8000 - 7000 = 1000 \) Hz. Una vez que ocurre, no hay forma de distinguir el alias de un tono real; por eso los convertidores analógico digitales aplican un filtro paso bajas antes de muestrear.
Esto explica las frecuencias de muestreo que encuentras en la práctica:
| Uso | \( f_s \) | Frecuencia máxima representable |
|---|---|---|
| Telefonía | 8 kHz | 4 kHz (suficiente para entender la voz) |
| Reconocimiento de voz | 16 kHz | 8 kHz (incluye las consonantes fricativas) |
| Audio de CD | 44.1 kHz | 22.05 kHz (por encima del oído humano) |
| Datos financieros diarios | 1 muestra por día | Ciclos de 2 días o más |
La transformada de Fourier: ver las frecuencias escondidas
La idea de Fourier es que cualquier señal razonable se puede escribir como una suma de senoidales. La transformada de Fourier hace el trabajo inverso: recibe la señal en el tiempo y te dice cuánta energía hay en cada frecuencia. Para una señal muestreada de \( N \) puntos se usa la transformada discreta (DFT):
\[ X_k = \sum_{n=0}^{N-1} x_n \, e^{-2\pi i k n / N}, \qquad k = 0, \dots, N-1 \]La intuición: cada \( X_k \) mide qué tanto se parece tu señal a una onda de frecuencia \( f_k = k f_s / N \). Calcularla directamente cuesta \( O(N^2) \) operaciones; la FFT (Fast Fourier Transform) obtiene el mismo resultado en \( O(N \log N) \), y por eso puedes analizar millones de muestras en milisegundos.
Prueba con una señal que mezcla dos tonos y mucho ruido. En el tiempo es imposible distinguirlos a simple vista; en frecuencia saltan de inmediato:
rng = np.random.default_rng(42)
fs = 1_000
t = np.arange(0, 1, 1 / fs)

senal = (1.0 * np.sin(2 * np.pi * 50 * t)            # 50 Hz, amplitud 1
         + 0.5 * np.sin(2 * np.pi * 120 * t + 1.0)   # 120 Hz, amplitud 0.5, fase 1 rad
         + rng.normal(0, 0.8, t.size))               # ruido fuerte

X = np.fft.rfft(senal)
freqs = np.fft.rfftfreq(senal.size, d=1 / fs)
amplitud = 2 * np.abs(X) / senal.size    # escala a la amplitud original

for i in sorted(np.argsort(amplitud)[::-1][:3]):
    print(f"{freqs[i]:6.1f} Hz  amplitud = {amplitud[i]:.3f}")

i120 = np.argmin(np.abs(freqs - 120))
print(f"Fase recuperada a 120 Hz: {np.angle(X[i120]) + np.pi / 2:.2f} rad")
print(f"Resolución en frecuencia: {freqs[1] - freqs[0]:.1f} Hz")
50.0 Hz amplitud = 0.982
120.0 Hz amplitud = 0.521
171.0 Hz amplitud = 0.126
Fase recuperada a 120 Hz: 1.03 rad
Resolución en frecuencia: 1.0 Hz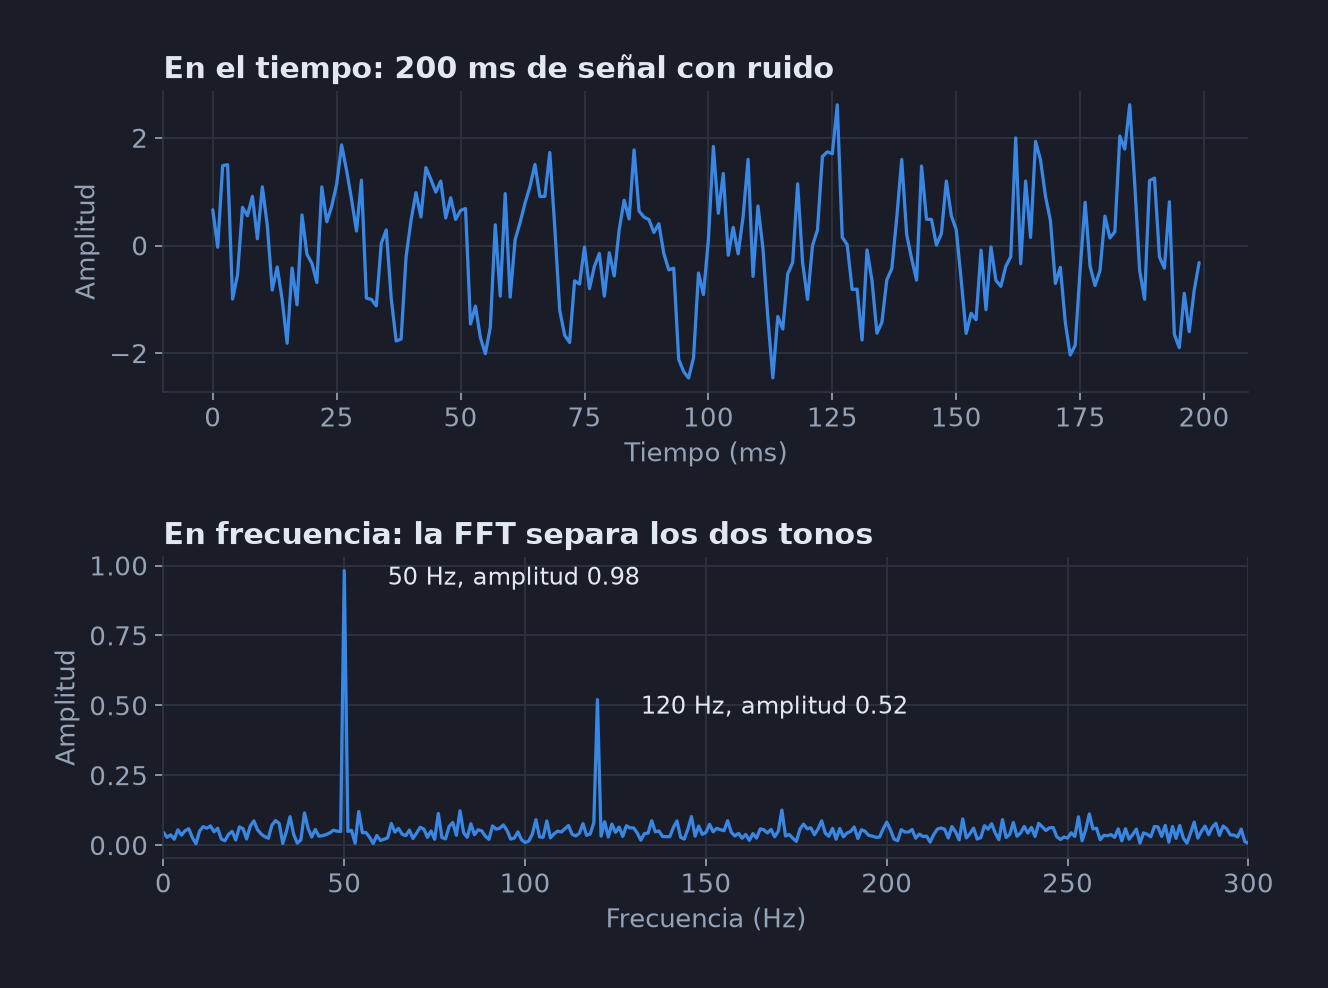
Tres detalles que conviene entender del código:
rfften lugar defft: para señales reales el espectro es simétrico, así querfftsolo calcula las frecuencias de 0 a \( f_s/2 \). Es más rápido y evita duplicados.- El factor \( 2|X_k|/N \): convierte la magnitud de la FFT a la amplitud original de cada senoidal. Por eso recuperas 0.98 y 0.52 en lugar de 1.0 y 0.5; la diferencia es el ruido.
- Resolución \( \Delta f = f_s / N = 1/T \): depende solo de cuánto tiempo observas. Con 1 segundo distingues frecuencias separadas 1 Hz; para separar tonos más cercanos necesitas más tiempo de señal, no más muestras por segundo.
El tercer pico (171 Hz) es ruido; distinguir picos reales de ruido será clave en finanzas.
Tip: si la frecuencia real no cae justo en un múltiplo de \( \Delta f \), su energía se "derrama" en las frecuencias vecinas (fuga espectral). Multiplicar la señal por una ventana, como
np.hanning(N), antes de la FFT reduce ese derrame a cambio de picos un poco más anchos.
Ondas de audio: analizar la pronunciación
La voz humana se describe muy bien con el modelo fuente filtro. Las cuerdas vocales vibran y generan pulsos periódicos (la fuente); su frecuencia es el tono fundamental \( F_0 \), unos 120 Hz en una voz masculina y unos 210 Hz en una femenina. Después, la boca y la garganta funcionan como un filtro que refuerza ciertas bandas de frecuencia llamadas formantes.
La clave para la pronunciación es esta: el tono dice quién habla; los formantes dicen qué vocal dice. El primer formante \( F_1 \) sube cuando abres la boca y el segundo \( F_2 \) sube cuando la lengua va hacia adelante. Con solo \( F_1 \) y \( F_2 \) puedes distinguir las cinco vocales del español.
El siguiente código sintetiza vocales con ese modelo y luego las analiza como si fueran grabaciones: estima \( F_0 \) con autocorrelación (la señal se parece a sí misma desplazada un periodo) y los formantes con predicción lineal (LPC), que ajusta un filtro cuyas resonancias son justamente los formantes:
from scipy.linalg import solve_toeplitz
from scipy.signal import lfilter

fs = 16_000
# Formantes F1, F2, F3 aproximados de las vocales del español (voz masculina, Hz)
FORMANTES = {
    "a": (700, 1300, 2500), "e": (450, 1900, 2500), "i": (270, 2300, 3000),
    "o": (470, 1000, 2500), "u": (290, 750, 2400),
}
ANCHOS = (90, 110, 170)   # ancho de banda de cada formante (Hz)


def sintetizar(formantes, f0=120, dur=0.5):
    """Modelo fuente-filtro: pulsos glotales filtrados por resonadores."""
    fuente = np.zeros(int(fs * dur))
    fuente[::round(fs / f0)] = 1.0
    y = fuente
    for F, B in zip(formantes, ANCHOS):
        r = np.exp(-np.pi * B / fs)
        theta = 2 * np.pi * F / fs
        y = lfilter([1 - r], [1, -2 * r * np.cos(theta), r ** 2], y)
    return y / np.max(np.abs(y))


def ventana(x):
    """40 ms del centro estable de la vocal."""
    return x[2_000:2_640]


def estimar_f0(x, fmin=60, fmax=400):
    """Tono fundamental por autocorrelación."""
    trozo = ventana(x) - ventana(x).mean()
    ac = np.correlate(trozo, trozo, mode="full")[trozo.size - 1:]
    lo, hi = int(fs / fmax), int(fs / fmin)
    return fs / (lo + np.argmax(ac[lo:hi]))


def estimar_formantes(x, orden=10):
    """F1, F2, F3 por predicción lineal (LPC)."""
    trozo = ventana(x)
    trozo = np.append(trozo[0], trozo[1:] - 0.63 * trozo[:-1])   # preénfasis
    trozo = trozo * np.hamming(trozo.size)
    r = np.correlate(trozo, trozo, mode="full")[trozo.size - 1:][: orden + 1]
    a = solve_toeplitz(r[:orden], r[1 : orden + 1])
    raices = np.roots(np.r_[1, -a])
    raices = raices[np.imag(raices) > 0]
    freqs = np.sort(np.angle(raices) * fs / (2 * np.pi))
    return freqs[freqs > 90][:3]


for v in "aei":
    voz = sintetizar(FORMANTES[v])
    F1, F2, F3 = estimar_formantes(voz)
    print(f"/{v}/  F0 = {estimar_f0(voz):5.1f} Hz   F1 = {F1:4.0f}  F2 = {F2:4.0f}  F3 = {F3:4.0f}")
/a/ F0 = 120.3 Hz F1 = 739 F2 = 1337 F3 = 2589
/e/ F0 = 120.3 Hz F1 = 469 F2 = 1915 F3 = 2510
/i/ F0 = 120.3 Hz F1 = 265 F2 = 2293 F3 = 2987El análisis recupera el tono (120.3 Hz, porque los pulsos caen cada 133 muestras) y los dos primeros formantes con un error de 5 a 40 Hz, más que suficiente para distinguir vocales (F3 se desvía más, hasta 89 Hz en la /a/, pero no hace falta para identificarlas). LPC funciona porque modela cada muestra como combinación lineal de las anteriores; las raíces del polinomio de ese modelo son resonancias, y sus ángulos se convierten en frecuencias con \( f = \theta f_s / 2\pi \).
Con eso ya puedes construir el núcleo de una aplicación de práctica de pronunciación: comparar los formantes del estudiante contra la vocal que debía decir.
def diagnosticar(voz, objetivo):
    """Vocal más cercana en el plano (F1, F2) y distancia a la vocal objetivo."""
    F1, F2, _ = estimar_formantes(voz)
    dist = {v: np.hypot(F1 - f[0], F2 - f[1]) for v, f in FORMANTES.items()}
    oida = min(dist, key=dist.get)
    print(f"Objetivo /{objetivo}/: F1 = {F1:.0f}, F2 = {F2:.0f} -> suena a /{oida}/, "
          f"a {dist[objetivo]:.0f} Hz del objetivo")


diagnosticar(sintetizar((460, 1880, 2500)), "e")   # buena pronunciación
diagnosticar(sintetizar((620, 1450, 2500)), "e")   # /e/ demasiado abierta
Objetivo /e/: F1 = 478, F2 = 1896 -> suena a /e/, a 28 Hz del objetivo
Objetivo /e/: F1 = 634, F2 = 1475 -> suena a /a/, a 463 Hz del objetivoLa segunda /e/ está demasiado abierta (\( F_1 \) alto) y retraída (\( F_2 \) bajo): queda más cerca de la /a/ que de la /e/. Esa es exactamente la retroalimentación que necesita alguien que aprende español: "cierra un poco la boca y adelanta la lengua". Las apps de idiomas refinan esto con escalas perceptuales como Bark o Mel.
El espectrograma: Fourier por ventanas
Una sola FFT te da las frecuencias de toda la señal, pero la voz cambia cada pocos milisegundos. El espectrograma resuelve eso: corta la señal en ventanas cortas que se traslapan, calcula una FFT por ventana y acomoda los resultados en una imagen de tiempo contra frecuencia. A esto se le llama transformada de Fourier de tiempo corto (STFT), y SciPy la implementa en ShortTimeFFT:
from scipy.io import wavfile
from scipy.signal import ShortTimeFFT
from scipy.signal.windows import hann

frase = np.concatenate([sintetizar(FORMANTES[v], dur=0.3) for v in "aeiou"])
wavfile.write("vocales.wav", fs, (0.8 * frase * 32_767).astype(np.int16))

stft = ShortTimeFFT(hann(512, sym=False), hop=128, fs=fs, scale_to="magnitude")
S = stft.spectrogram(frase)          # potencia por (frecuencia, tiempo)
print(f"Espectrograma: {S.shape[0]} frecuencias x {S.shape[1]} ventanas")
print(f"Resolución: {stft.delta_f:.2f} Hz en frecuencia, {1000 * stft.delta_t:.0f} ms en tiempo")
Espectrograma: 257 frecuencias x 191 ventanas
Resolución: 31.25 Hz en frecuencia, 8 ms en tiempo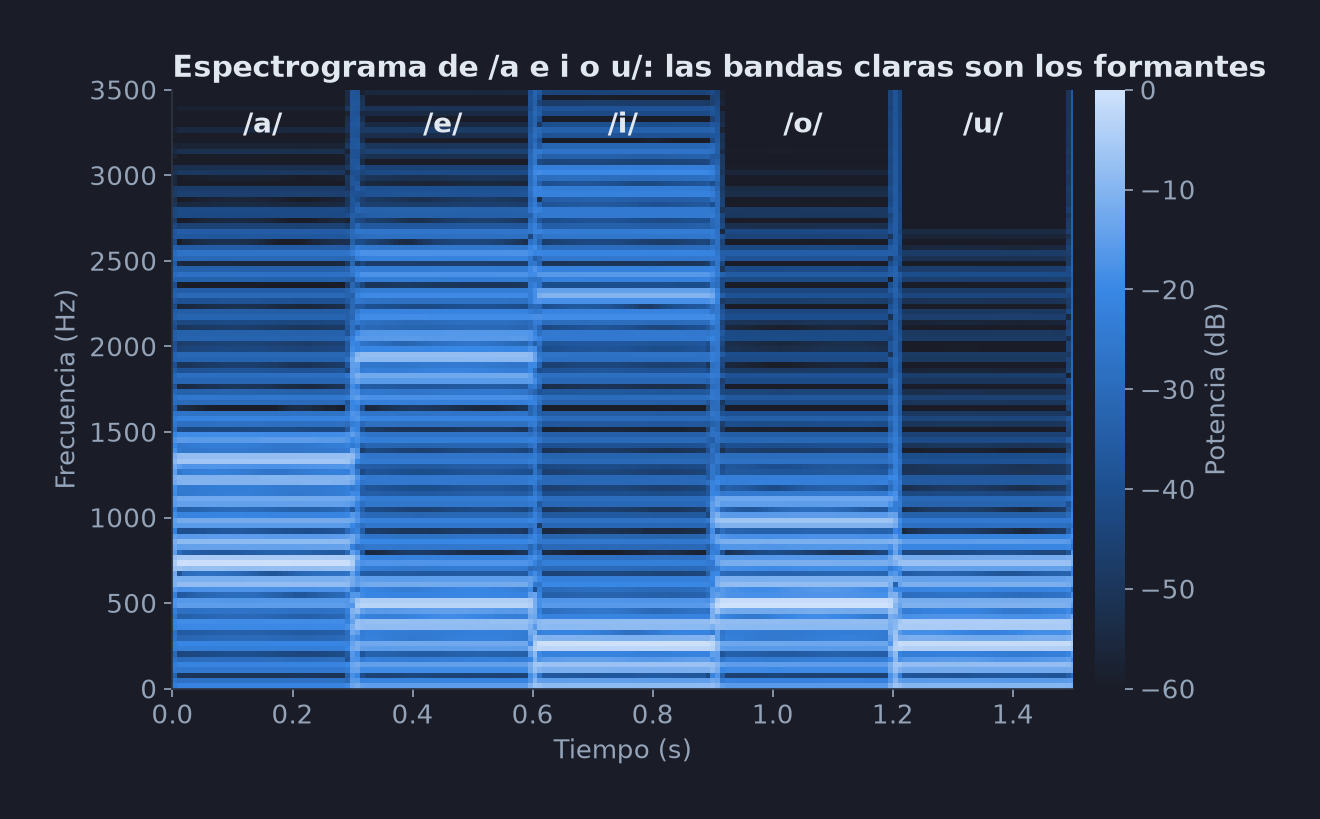
Las rayas horizontales finas son los armónicos del tono (múltiplos de 120 Hz) y las zonas brillantes son los formantes. El archivo vocales.wav que genera el código se puede reproducir: escucharás las cinco vocales con timbre robótico, porque el modelo no tiene las variaciones naturales de una voz real.
La ventana de 512 muestras es una decisión de ingeniería, no un detalle: es el principio de incertidumbre del análisis de señales. Ventanas largas dan buena resolución en frecuencia (31.25 Hz alcanza para ver armónicos separados por 120 Hz) pero difuminan los cambios rápidos; ventanas cortas hacen lo contrario. Para reconocimiento de voz se usan ventanas de 20 a 30 ms con saltos de 10 ms.
Tip: para grabaciones reales carga el audio con
scipy.io.wavfile.ready analiza solo las partes con voz. Si necesitas formantes con precisión de laboratorio, la libreríapraat-parselmouthexpone en Python los mismos algoritmos de Praat que usan los fonetistas.
Modulación AM y FM: cómo viaja la información
La voz ocupa frecuencias bajas que no viajan bien por el aire como onda de radio. La solución es la modulación: usar una onda de alta frecuencia, la portadora \( f_c \), y variar alguna de sus propiedades al ritmo del mensaje \( m(t) \).
- AM (amplitud modulada): el mensaje controla la amplitud. \( x(t) = [1 + \mu\, m(t)] \cos(2\pi f_c t) \), con índice de modulación \( \mu \).
- FM (frecuencia modulada): el mensaje controla la frecuencia instantánea. Con un tono de frecuencia \( f_m \), \( x(t) = \cos\big(2\pi f_c t + \beta \sin(2\pi f_m t)\big) \), con índice \( \beta \).
La transformada de Fourier muestra lo que cada una le hace al espectro. En el código, la portadora es de 1,000 Hz y el mensaje de 50 Hz (en la radio real la portadora está en kHz o MHz, pero la matemática es la misma):
from scipy.signal import hilbert
from scipy.special import jv

fs = 20_000
t = np.arange(0, 1, 1 / fs)
fc, fm = 1_000, 50                       # portadora y mensaje (Hz)
mensaje = np.cos(2 * np.pi * fm * t)

am = (1 + 0.5 * mensaje) * np.cos(2 * np.pi * fc * t)     # índice de modulación 0.5
beta = 2.0
fm_senal = np.cos(2 * np.pi * fc * t + beta * np.sin(2 * np.pi * fm * t))


def amplitud_en(x, f):
    X = 2 * np.abs(np.fft.rfft(x)) / x.size
    return X[int(round(f * x.size / fs))]


print("AM:", {f: round(float(amplitud_en(am, f)), 3) for f in (fc - fm, fc, fc + fm)})

print(" k  medido  teoría |J_k(2)|")
for k in range(5):
    print(f"{k:>2}  {amplitud_en(fm_senal, fc + k * fm):.3f}   {abs(jv(k, beta)):.3f}")

envolvente = np.abs(hilbert(am))
print(f"Error máximo al demodular AM: {np.max(np.abs(envolvente - (1 + 0.5 * mensaje))):.4f}")

P = np.abs(np.fft.rfft(fm_senal)) ** 2
f_ax = np.fft.rfftfreq(fm_senal.size, 1 / fs)
banda = np.abs(f_ax - fc) <= (beta + 1) * fm          # regla de Carson: 2(beta + 1) fm
print(f"Potencia FM dentro de {2 * (beta + 1) * fm:.0f} Hz (Carson): {P[banda].sum() / P.sum():.1%}")
AM: {950: 0.25, 1000: 1.0, 1050: 0.25}
k medido teoría |J_k(2)|
0 0.224 0.224
1 0.577 0.577
2 0.353 0.353
3 0.129 0.129
4 0.034 0.034
Error máximo al demodular AM: 0.0000
Potencia FM dentro de 300 Hz (Carson): 99.8%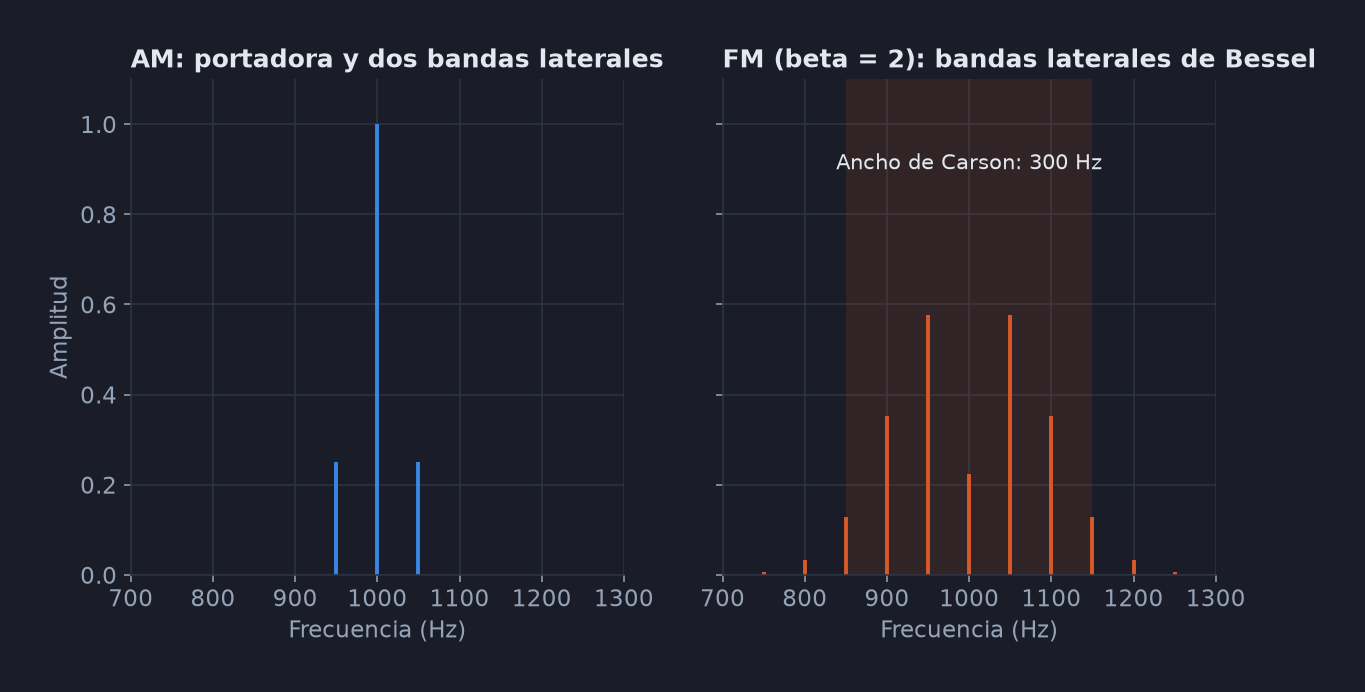
Lo que confirma el código:
- AM produce la portadora y dos bandas laterales en \( f_c \pm f_m \), cada una con amplitud \( \mu/2 = 0.25 \). Para recuperar el mensaje basta con la envolvente, que se calcula con la transformada de Hilbert (
scipy.signal.hilbert); el error de demodulación es prácticamente cero. - FM produce bandas laterales en \( f_c \pm k f_m \) con amplitudes dadas por las funciones de Bessel \( |J_k(\beta)| \). La medición coincide con la teoría hasta el tercer decimal.
- La regla de Carson, \( B \approx 2(\beta + 1) f_m \), predice el ancho de banda de FM: el 99.8% de la potencia cae dentro de 300 Hz.
| AM | FM | |
|---|---|---|
| Qué se modula | Amplitud | Frecuencia |
| Ancho de banda | \( 2 f_m \) | \( 2(\beta + 1) f_m \) |
| Resistencia al ruido | Baja: el ruido suma amplitud | Alta: la información está en la frecuencia |
| Uso típico | Radio AM, aviación | Radio FM, audio de TV, radios de dos vías |
Esa tabla resume una decisión de ingeniería clásica: FM gasta más espectro a cambio de calidad. Por eso las estaciones FM, que transmiten música, están separadas 200 kHz y las AM solo 10 kHz.
Fourier en análisis cuantitativo: ciclos en series financieras
Una serie de tiempo financiera también es una señal muestreada, con \( f_s \) = 1 muestra por día hábil. Su frecuencia de Nyquist es 0.5 ciclos por día: ningún análisis diario puede ver ciclos de menos de 2 días. La herramienta es el periodograma, que estima la potencia de cada frecuencia a partir de la FFT.
Empieza con un caso donde sí hay ciclos: el logaritmo del volumen de operación, con un efecto semanal (algunos días de la semana se opera más) y un ciclo mensual (por ejemplo, vencimientos de derivados), más tendencia y ruido autocorrelacionado:
from scipy.signal import detrend, find_peaks, periodogram

rng = np.random.default_rng(7)
n = 2_520                                   # ~10 años de días hábiles
dias = np.arange(n)

ruido = np.zeros(n)                         # ruido AR(1): cada día se parece al anterior
for i in range(1, n):
    ruido[i] = 0.6 * ruido[i - 1] + rng.normal(0, 0.15)

log_volumen = (13 + 0.0002 * dias                       # tendencia
               + 0.12 * np.sin(2 * np.pi * dias / 5)    # ciclo semanal (5 días hábiles)
               + 0.08 * np.sin(2 * np.pi * dias / 21)   # ciclo mensual (~21 días hábiles)
               + ruido)

f, P = periodogram(detrend(log_volumen), fs=1.0, window="hann")   # f en ciclos por día
picos, _ = find_peaks(P)                  # máximos locales: un pico por ciclo
for i in picos[np.argsort(P[picos])[::-1][:3]]:
    print(f"Periodo {1 / f[i]:6.1f} días  potencia {P[i] / np.median(P[1:]):6.1f} veces la mediana")
Periodo 5.0 días potencia 447.2 veces la mediana
Periodo 21.0 días potencia 114.8 veces la mediana
Periodo 47.5 días potencia 86.9 veces la medianaLos dos ciclos reales aparecen arriba: 5 y 21 días. Ahora mira el tercer lugar: un "ciclo" de 47.5 días con 87 veces la potencia mediana. Ese ciclo no existe en los datos. Es ruido rojo: cuando cada día se parece al anterior (el término AR(1) del código), el ruido acumula más potencia en frecuencias bajas y genera picos que parecen ciclos. Con datos reales no sabrías cuál de los tres es falso.
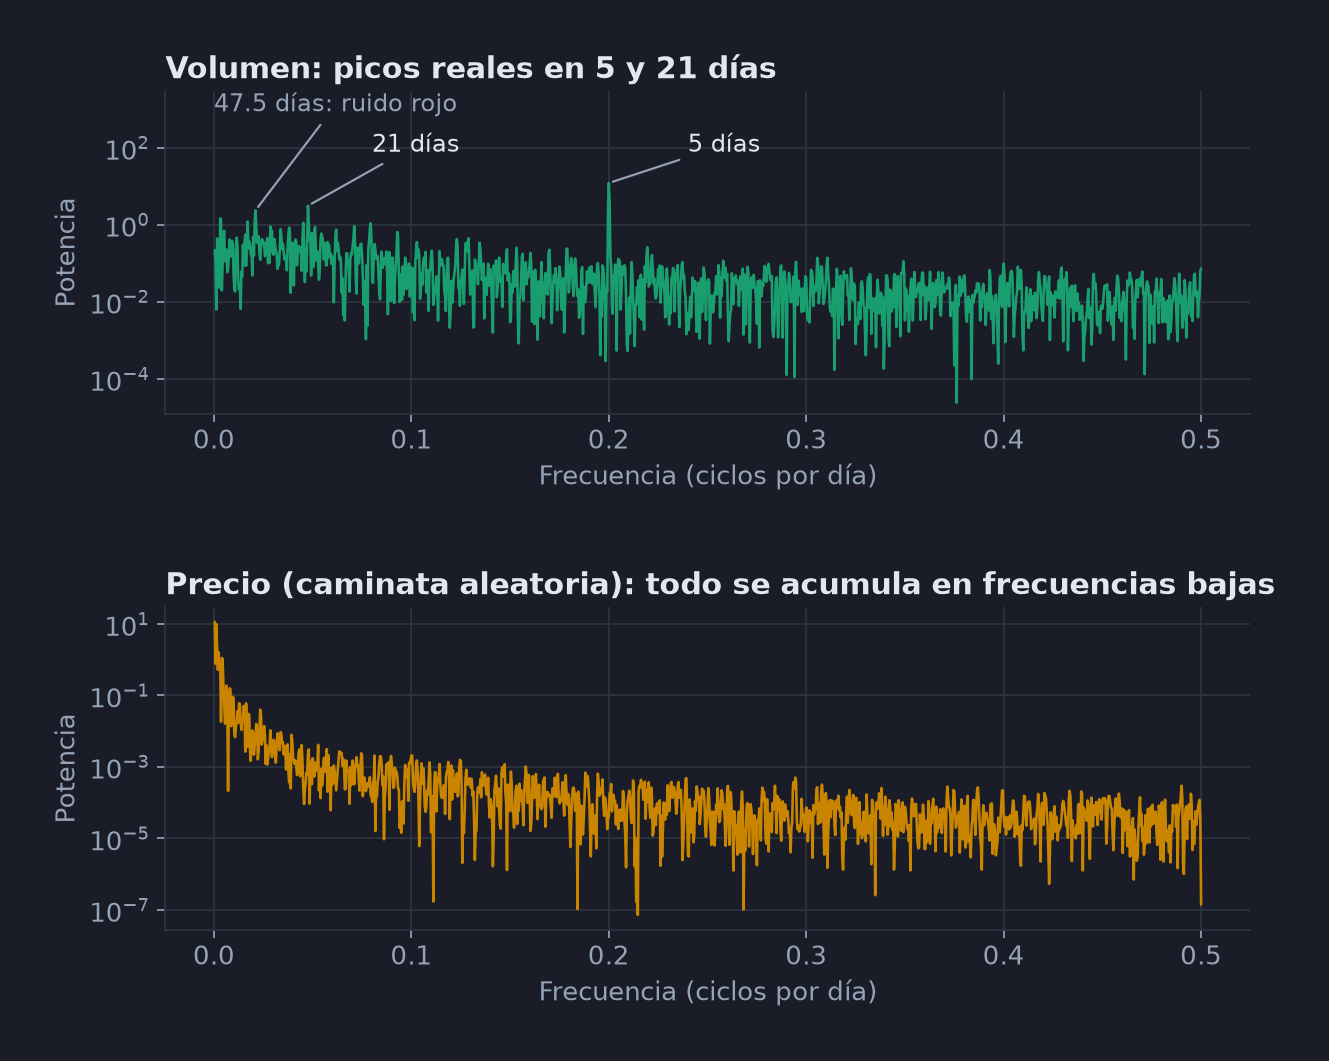
El problema es peor con precios. Un precio se comporta aproximadamente como una caminata aleatoria, y su espectro cae como \( 1/f^2 \): casi toda la potencia está en las frecuencias más bajas. Si le aplicas la FFT directamente, siempre vas a encontrar un "ciclo largo" muy fuerte, aunque no haya ninguno. La forma correcta es trabajar con rendimientos y comparar contra una hipótesis nula:
precio = 100 * np.exp(np.cumsum(rng.normal(0.0003, 0.01, n)))    # caminata aleatoria pura

f, P = periodogram(detrend(np.log(precio)), window="hann")
k = np.argmax(P[1:]) + 1
print(f"Precios: ciclo aparente de {1 / f[k]:.0f} días ({P[k] / np.median(P[1:]):.0f} veces la mediana)")

rend = np.diff(np.log(precio))              # rendimientos logarítmicos
f_r, P_r = periodogram(rend, window="hann")
k_r = np.argmax(P_r[1:]) + 1

# Hipótesis nula: rendimientos sin estructura temporal (barajados)
maximos = [periodogram(rng.permutation(rend), window="hann")[1][1:].max() for _ in range(500)]
umbral = np.percentile(maximos, 95)
print(f"Rendimientos: pico en {1 / f_r[k_r]:.1f} días, potencia {P_r[k_r]:.2e} (umbral 95%: {umbral:.2e})")
print("¿Ciclo significativo?", bool(P_r[k_r] > umbral))
Precios: ciclo aparente de 2520 días (130575 veces la mediana)
Rendimientos: pico en 3.4 días, potencia 1.47e-03 (umbral 95%: 2.04e-03)
¿Ciclo significativo? FalseEl precio, generado sin ningún ciclo, muestra un "ciclo" de 2,520 días: exactamente la longitud de la muestra. Es la firma de la no estacionariedad, no un descubrimiento. Con los rendimientos, el pico más alto (3.4 días) no supera el umbral del 95% construido barajando los datos: no hay evidencia de ningún ciclo, que es la respuesta correcta.
Las reglas que se desprenden para usar Fourier en finanzas:
- Usa series estacionarias: rendimientos, volumen sin tendencia o spreads, nunca precios en nivel.
- Compara contra una hipótesis nula: barajar los datos funciona para rendimientos; si la serie tiene autocorrelación, simula un modelo AR ajustado a tus datos para construir el umbral.
- Cuidado con las comparaciones múltiples: el periodograma prueba cientos de frecuencias a la vez; alguna saldrá alta por azar. Por eso el umbral se construye con el máximo de cada simulación, no con un valor individual.
Tip: el periodograma de una sola ventana es ruidoso.
scipy.signal.welchpromedia periodogramas de segmentos traslapados y da un estimado más estable, a cambio de menos resolución en frecuencia. Para series cortas o con huecos (días festivos), revisascipy.signal.lombscargle.
Conclusión
Las ondas en Python se reducen a unas cuantas ideas que se repiten en todos los campos. Una señal digital es una lista de muestras, y el teorema de Nyquist limita qué frecuencias puede contener. La transformada de Fourier, calculada con la FFT, cambia la pregunta de "qué valor tiene la señal en cada instante" a "cuánta energía hay en cada frecuencia", y esa segunda pregunta suele ser la útil.
Con esas herramientas analizaste la voz (tono fundamental, formantes con LPC y espectrogramas para evaluar la pronunciación de vocales), verificaste la teoría de la modulación AM y FM hasta las funciones de Bessel, y buscaste ciclos en series financieras distinguiendo los reales del ruido rojo y de la no estacionariedad. El patrón es siempre el mismo: transformar la señal, interpretar el espectro y, antes de tomar una decisión, comprobar que lo que ves no es un artefacto del muestreo, de la ventana o del ruido.